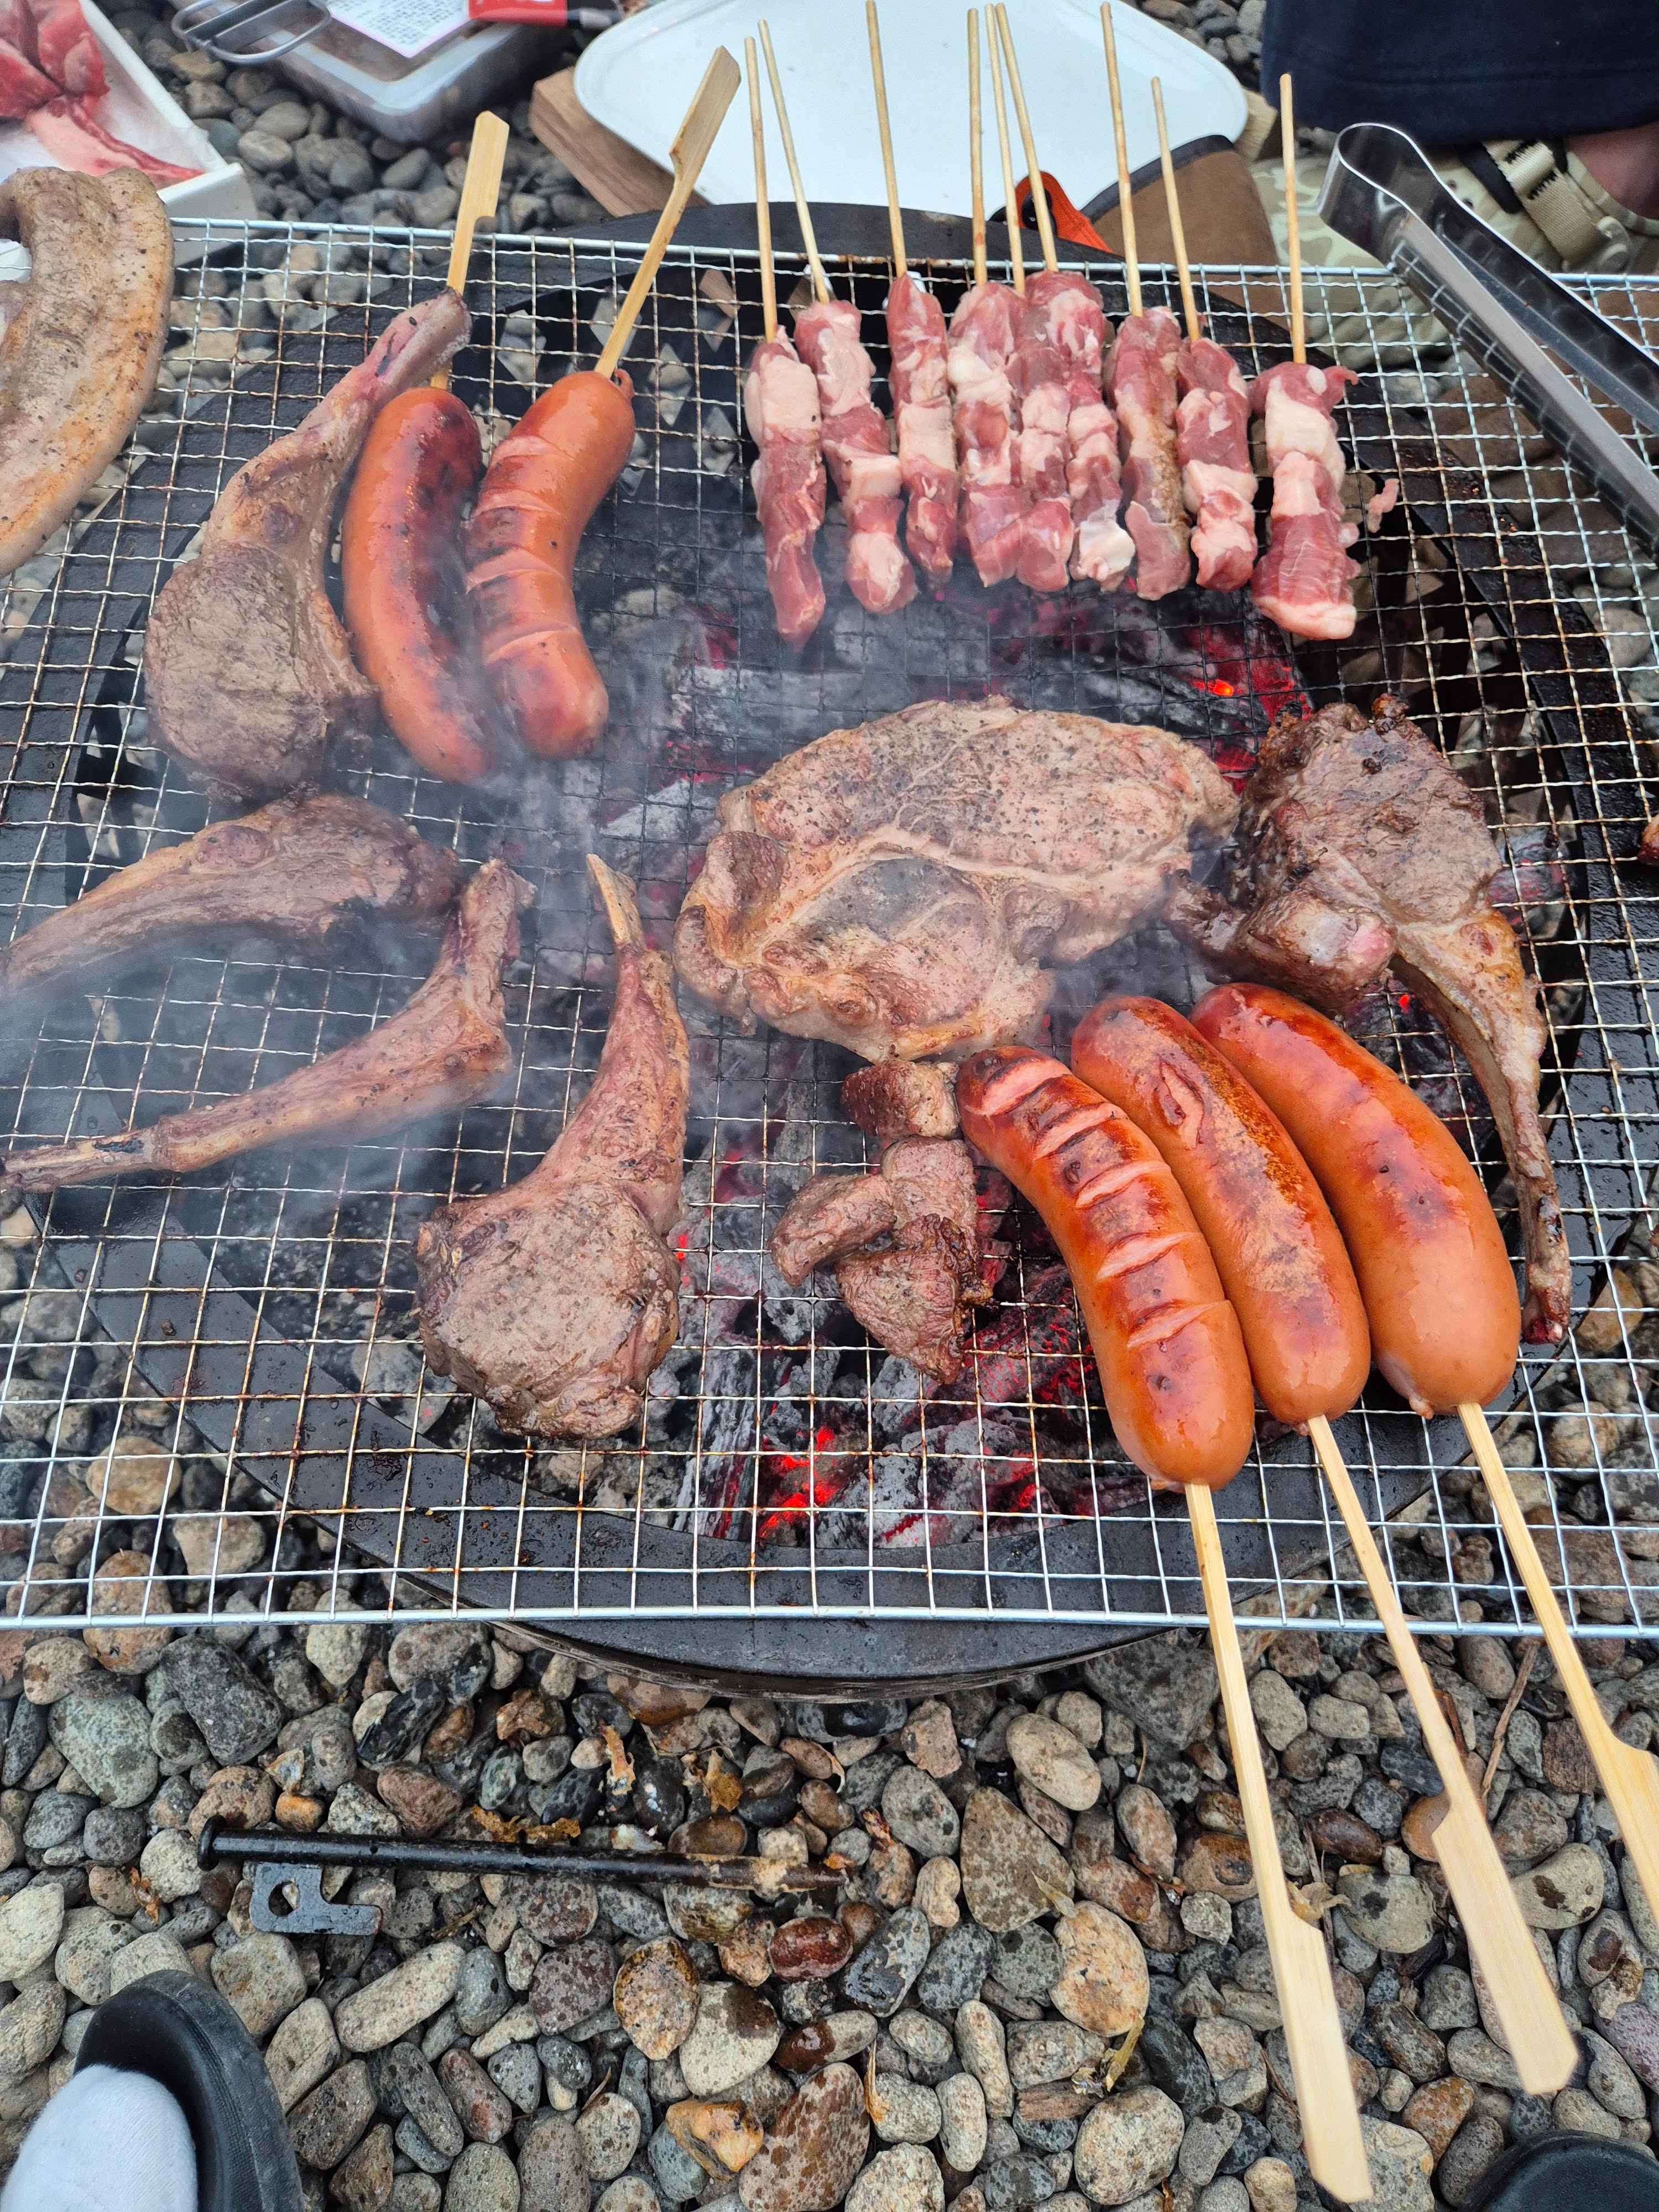
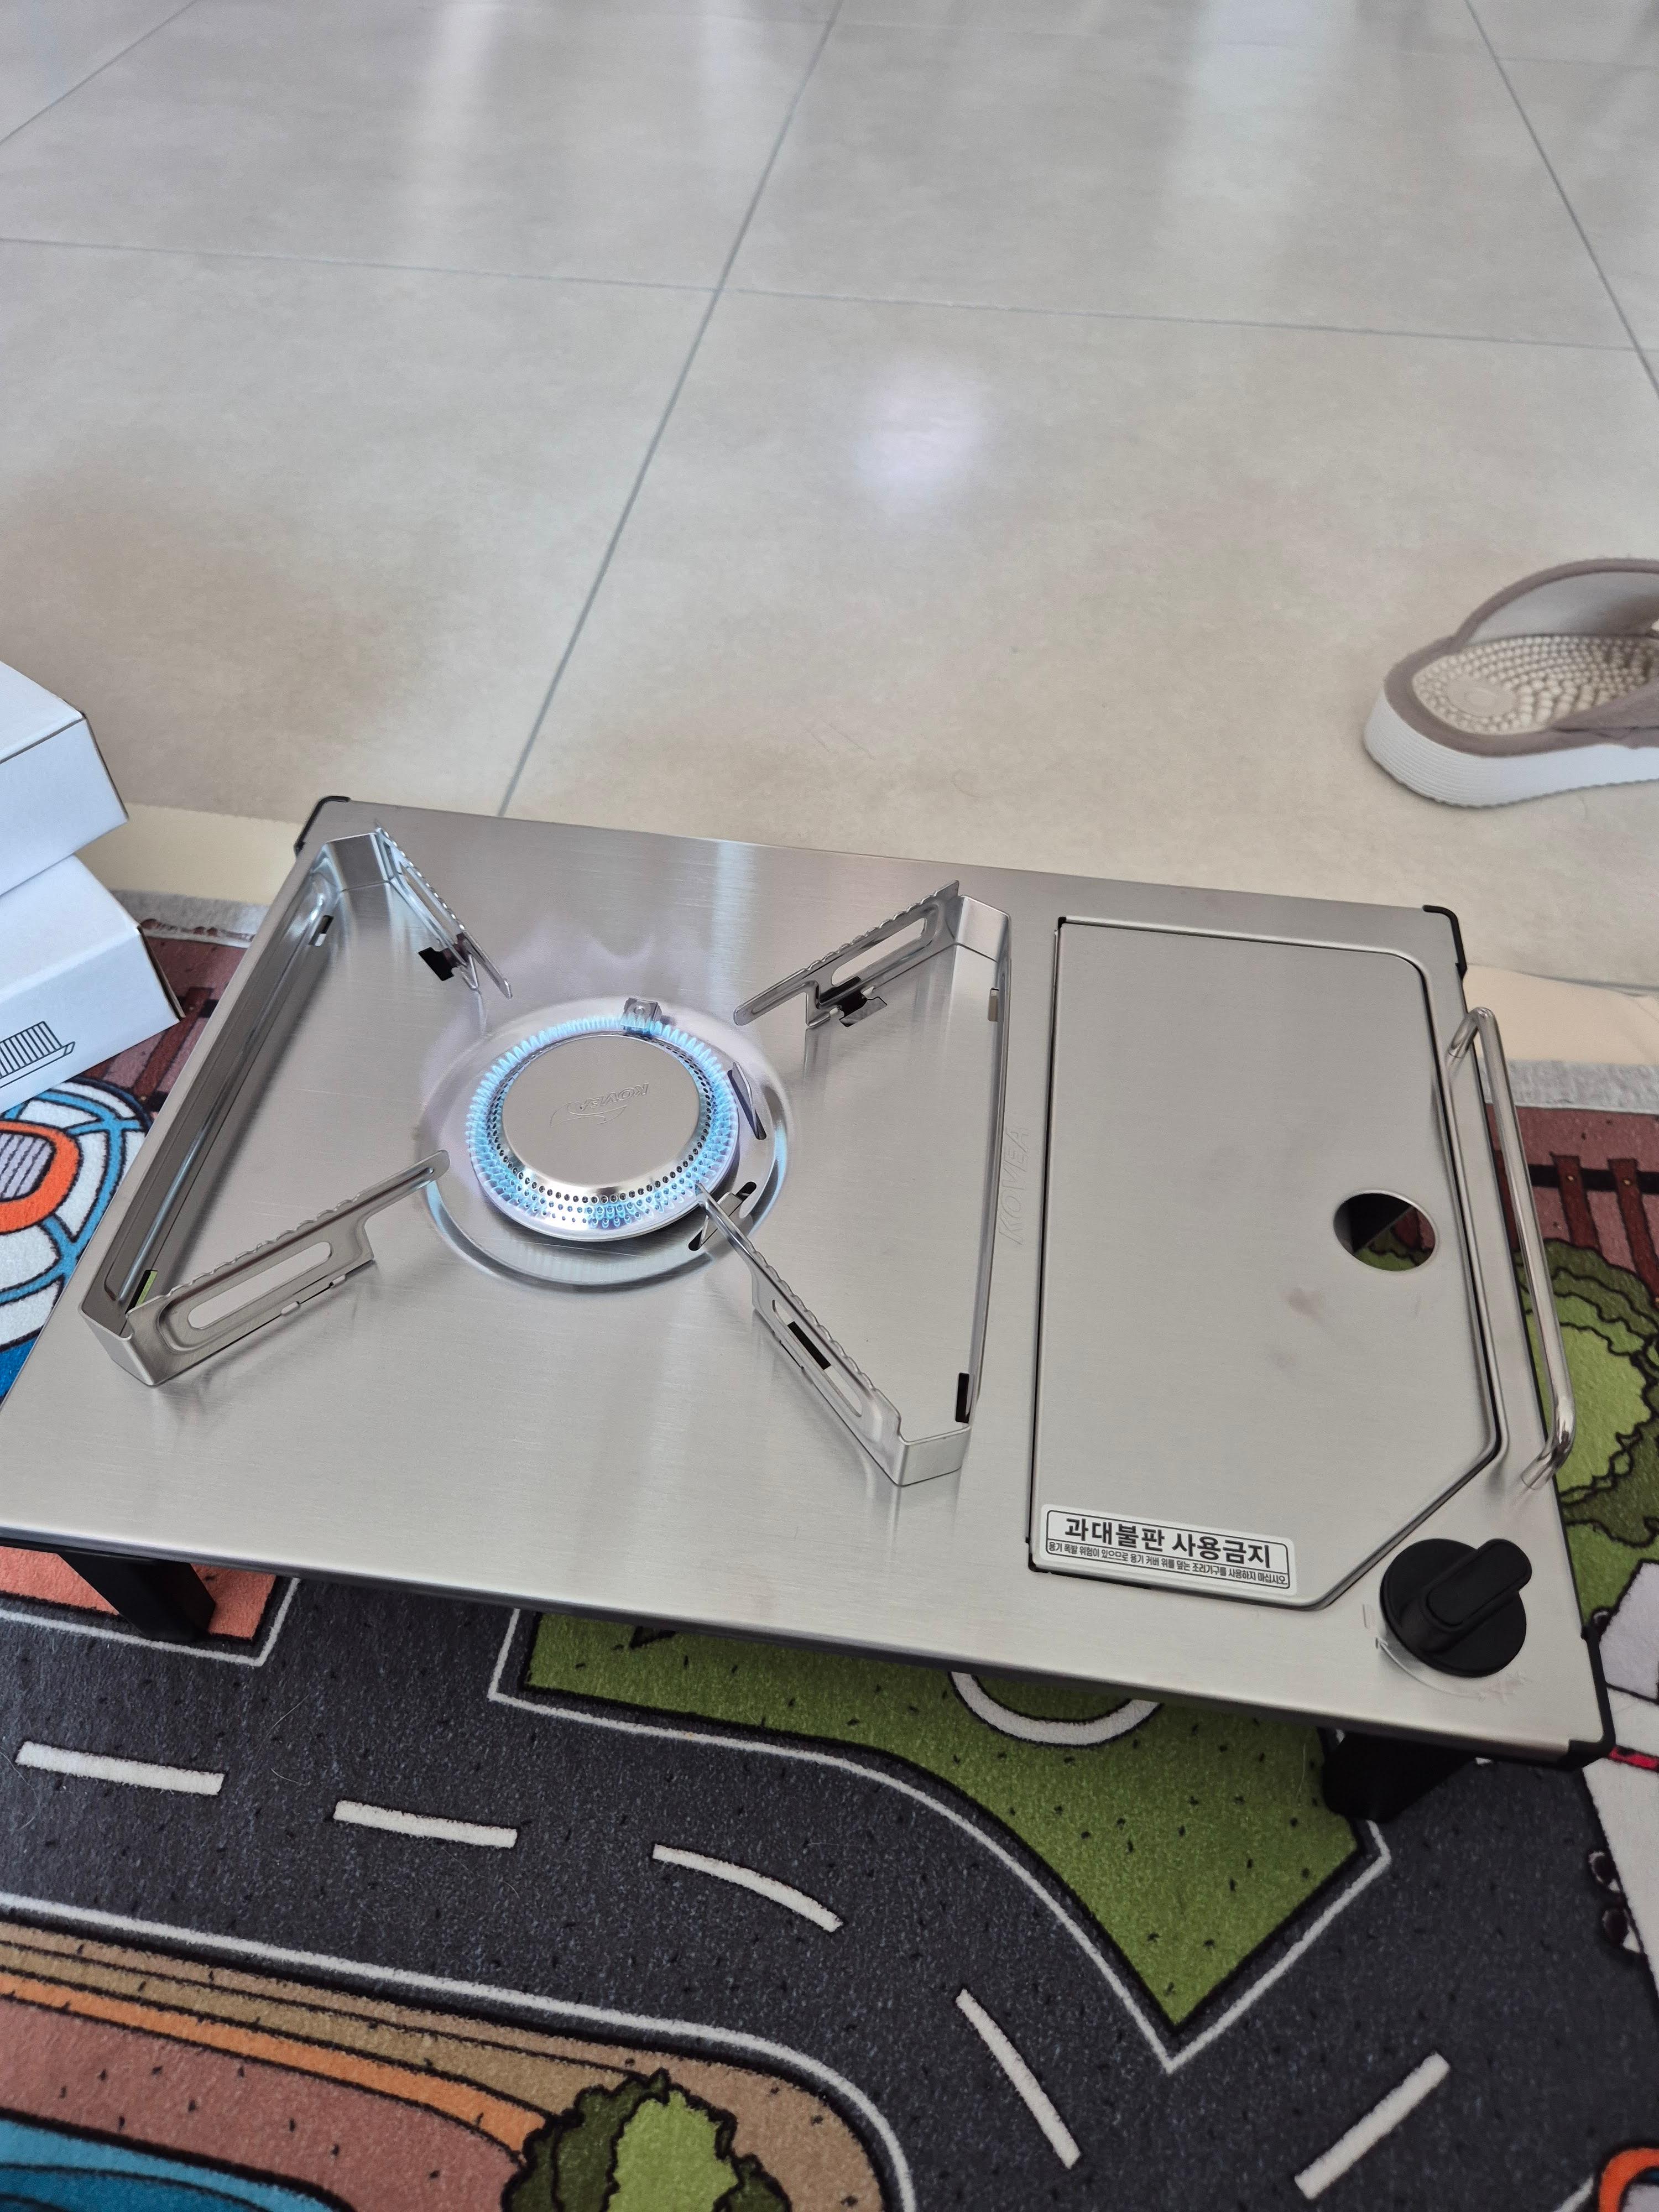
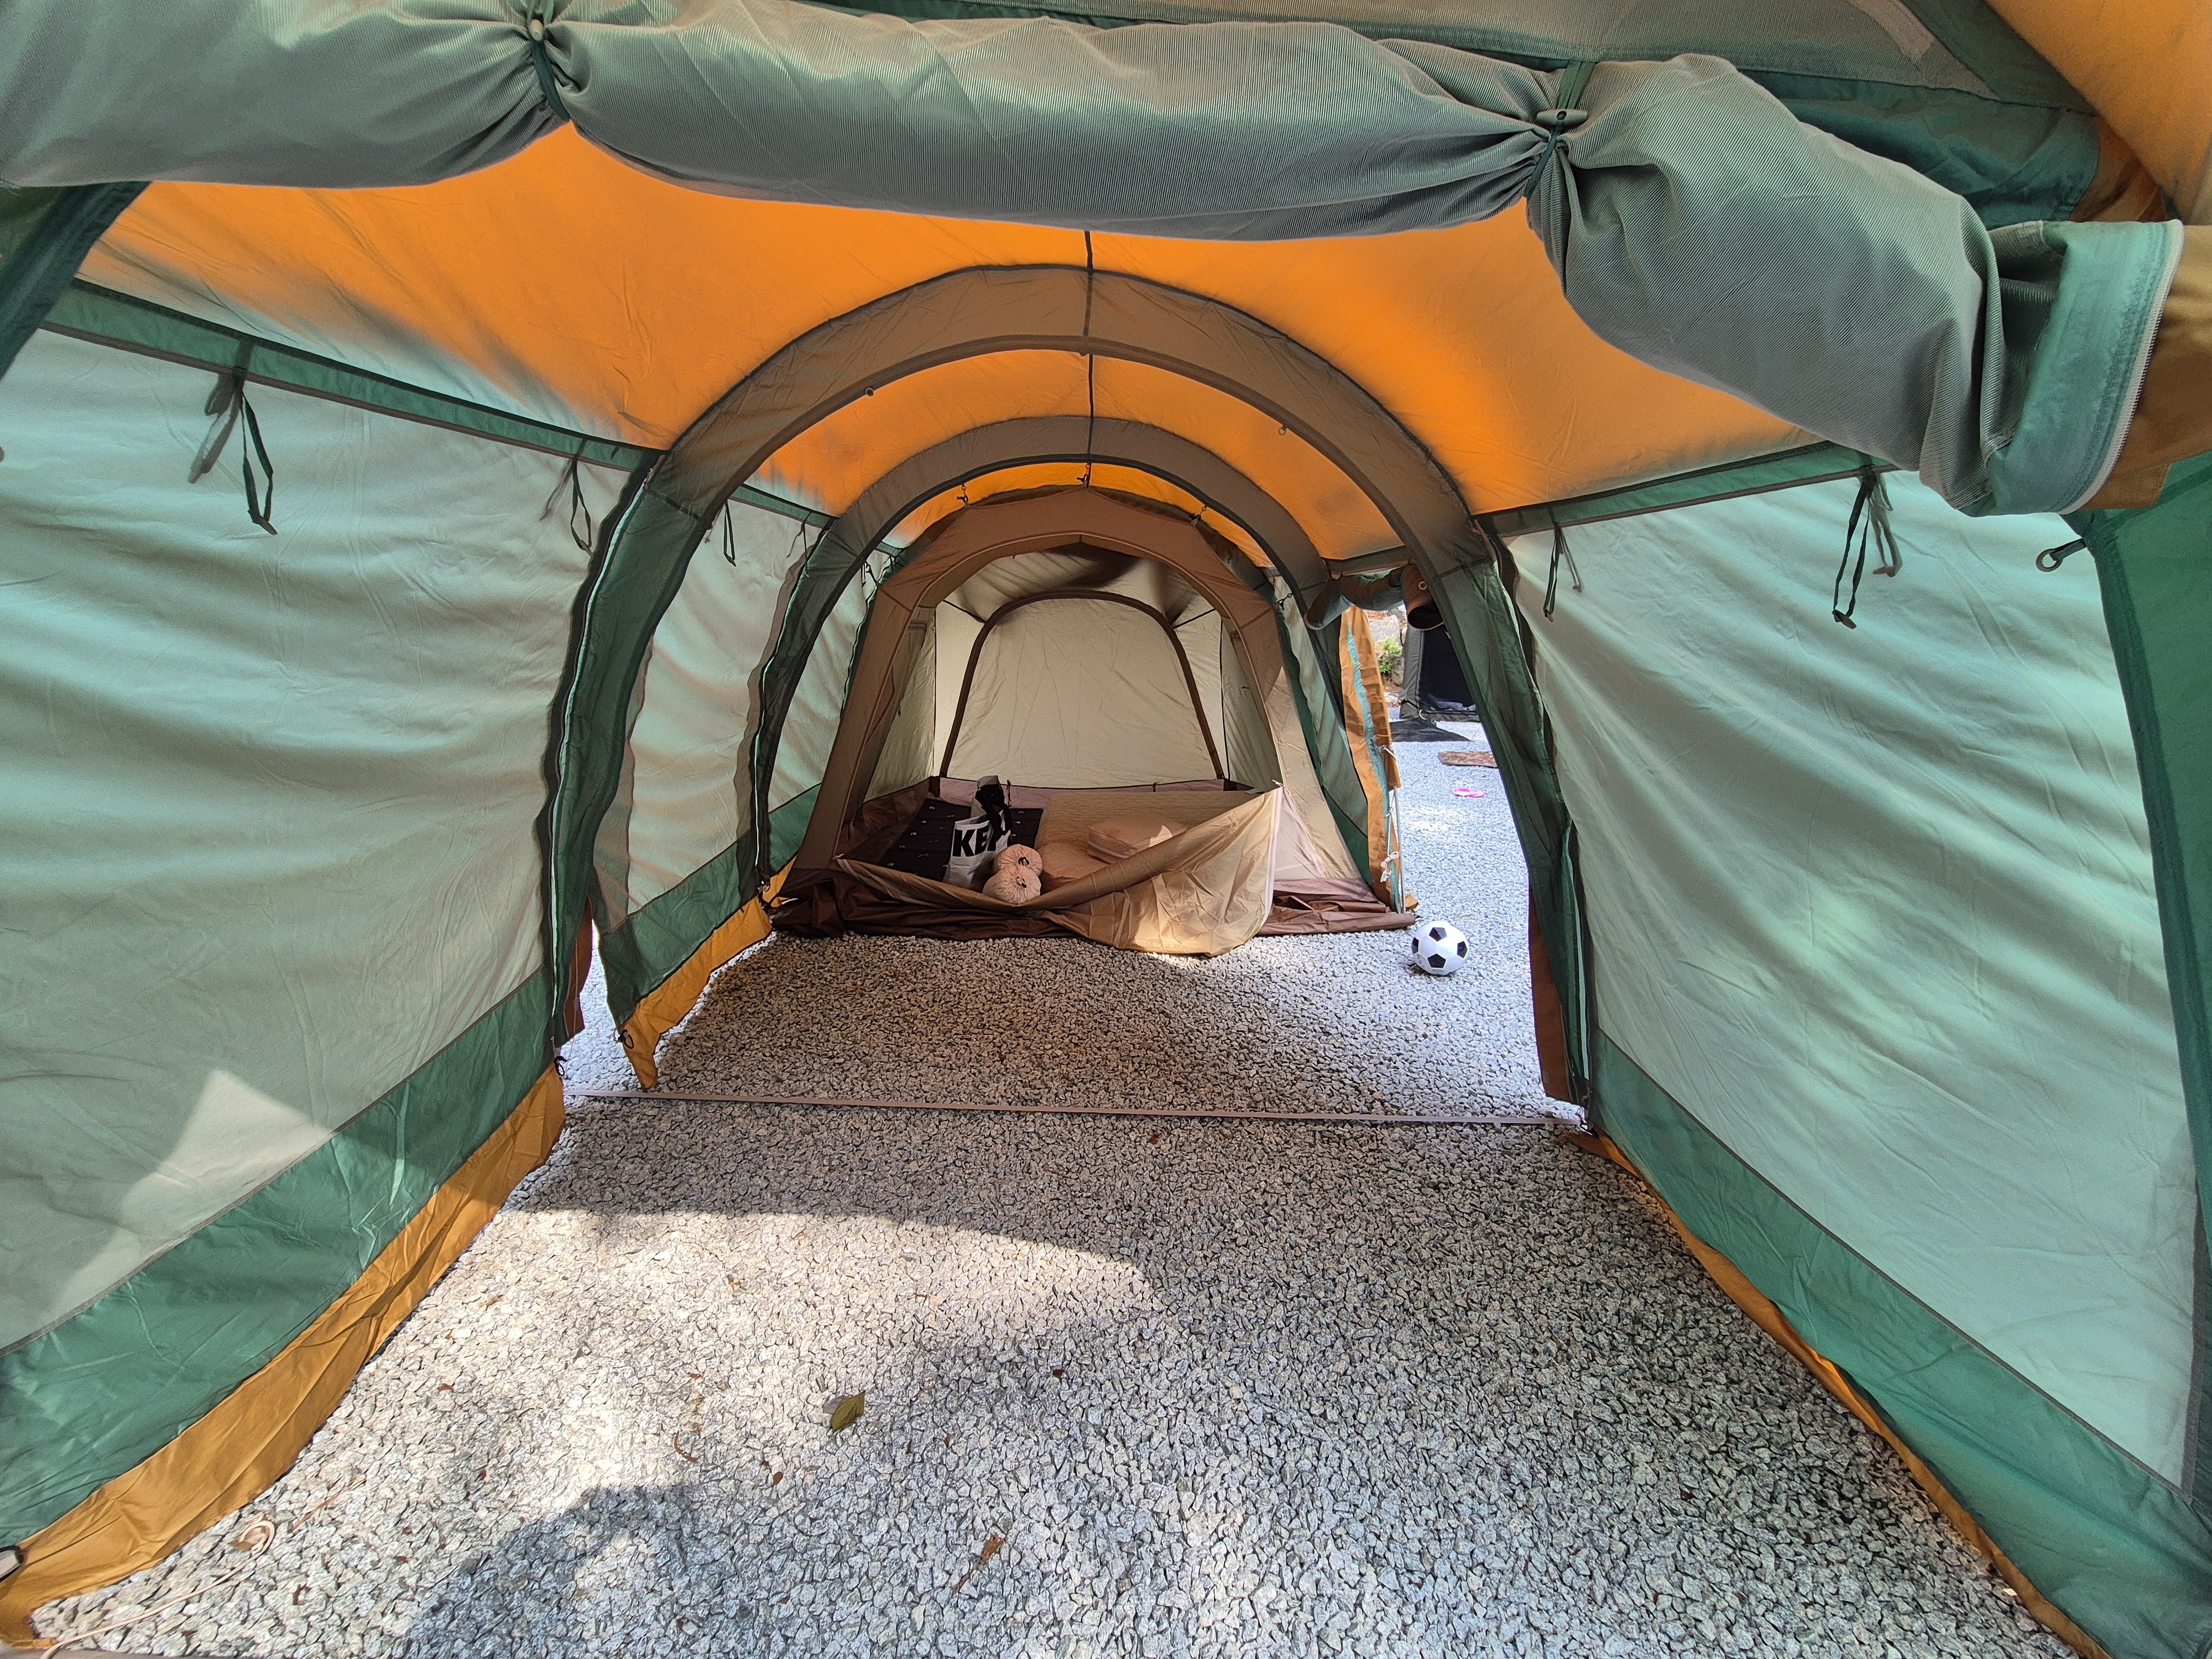
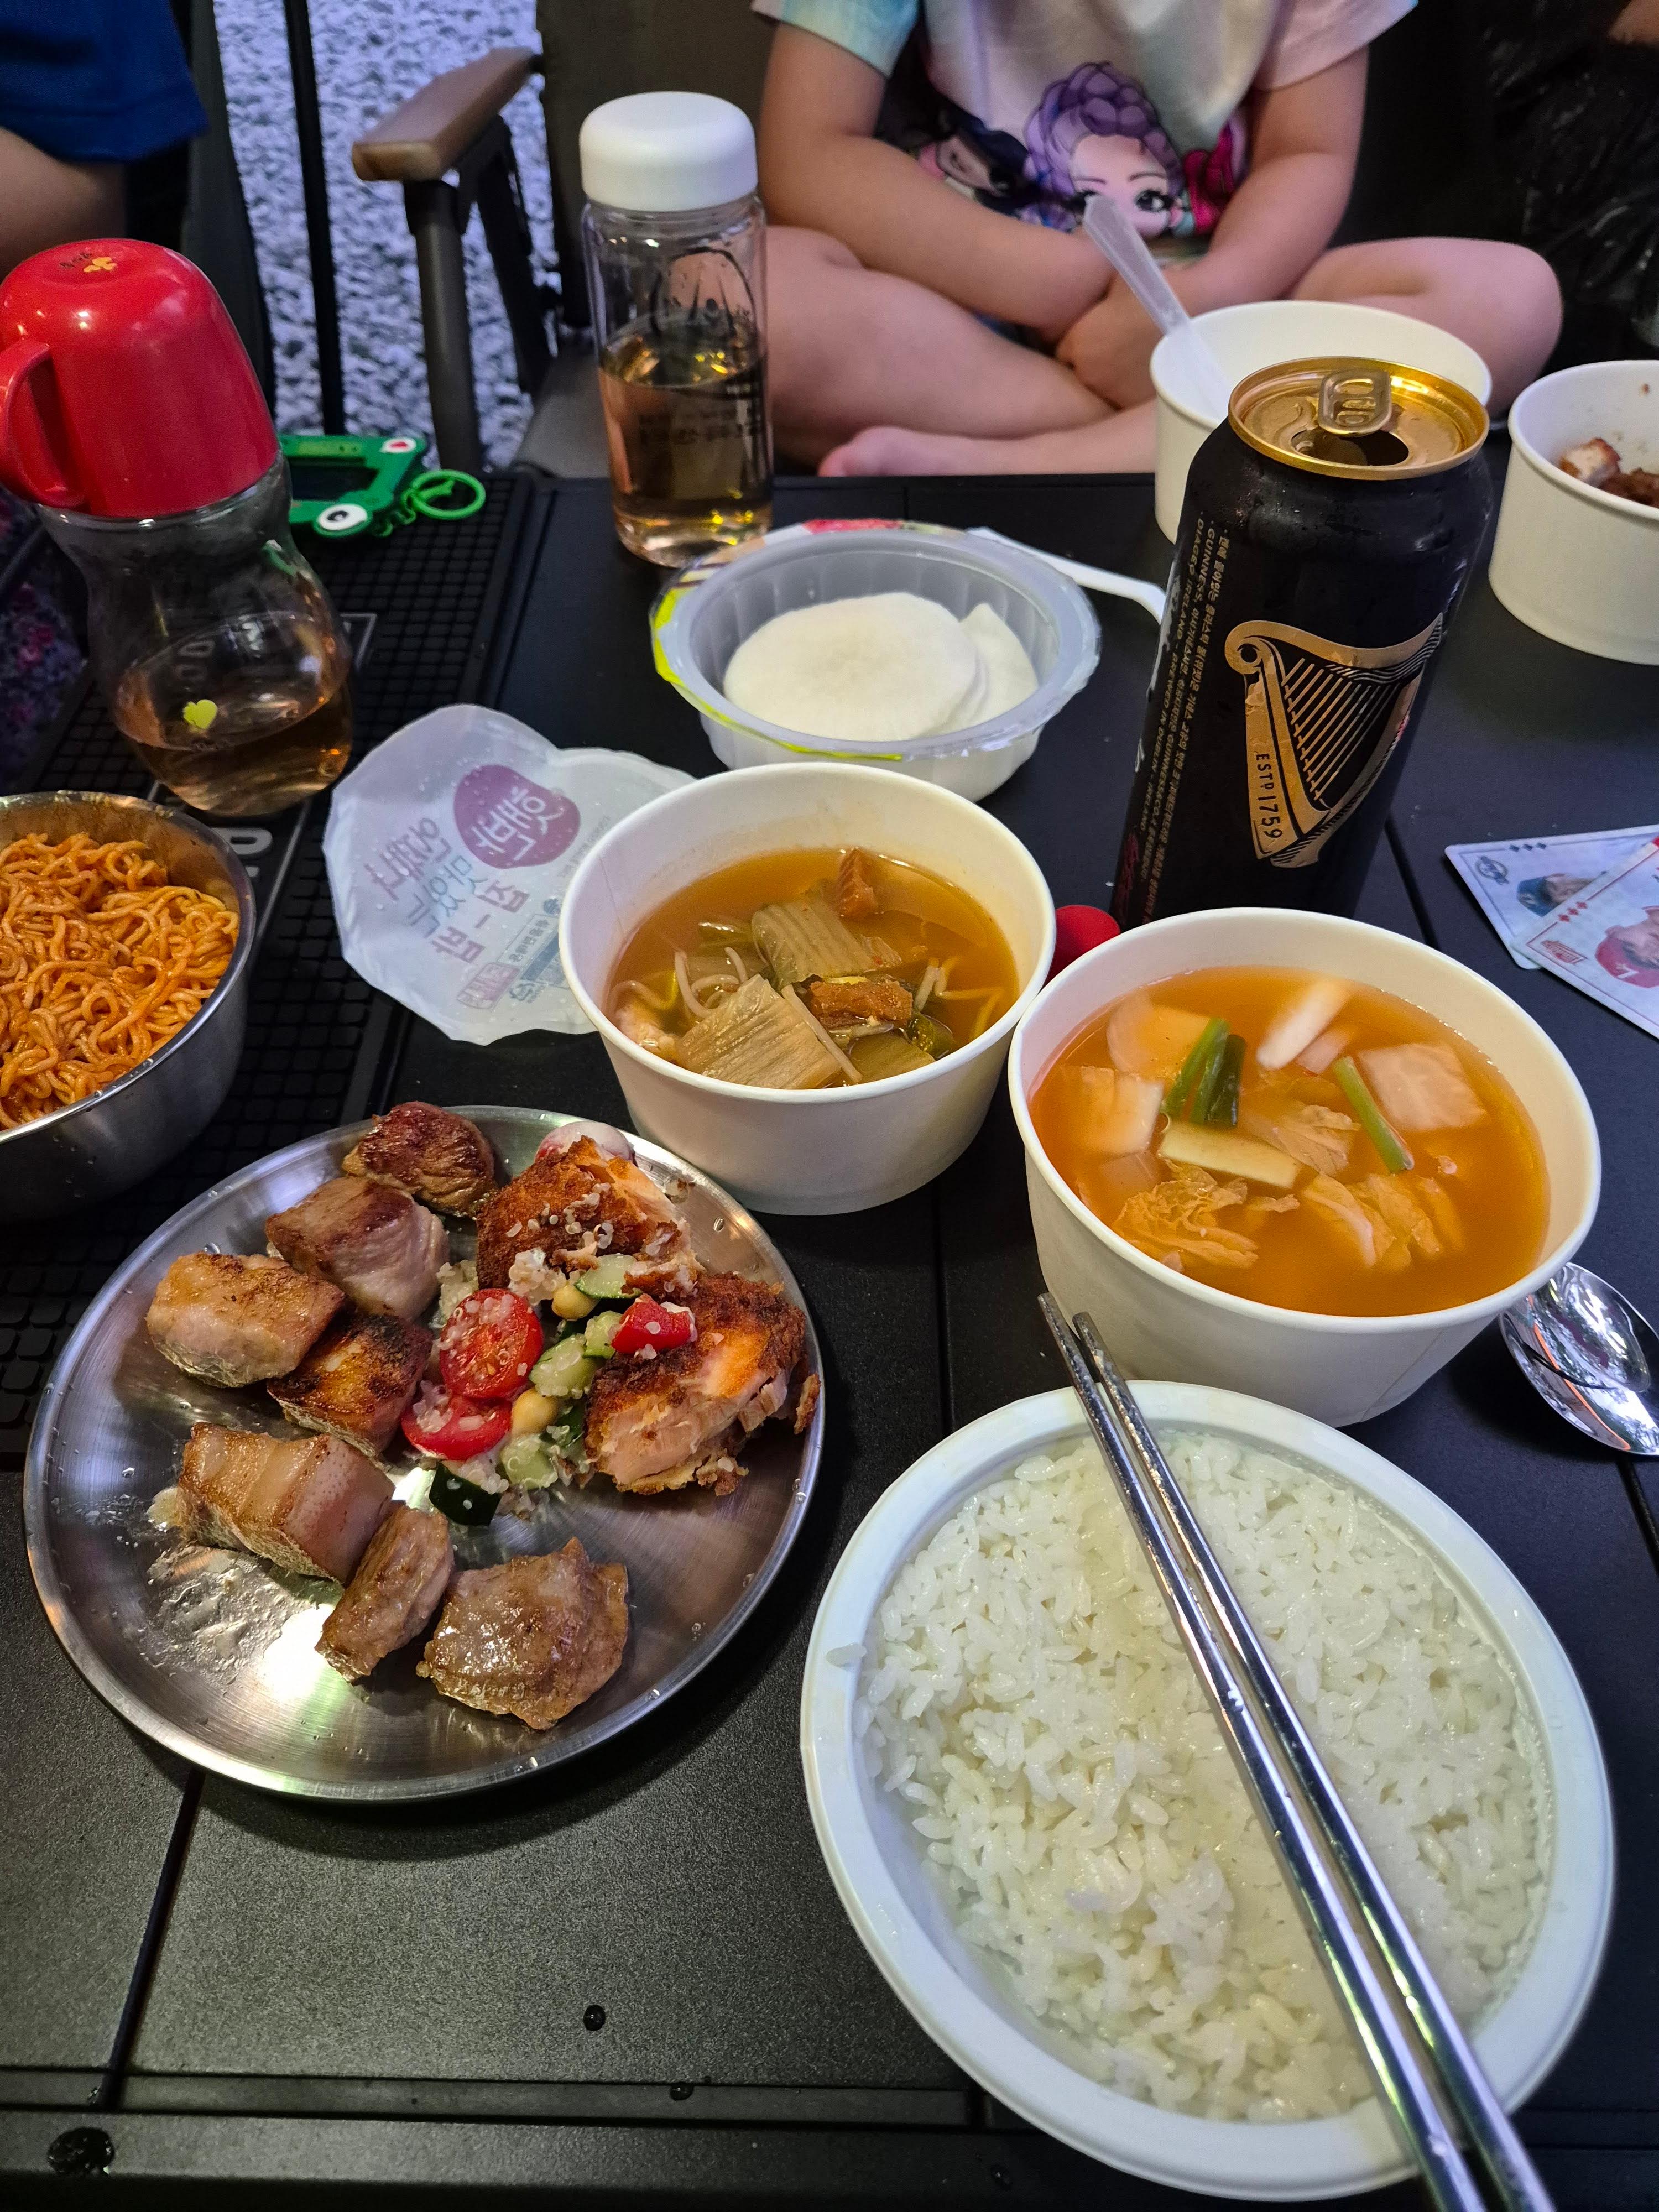
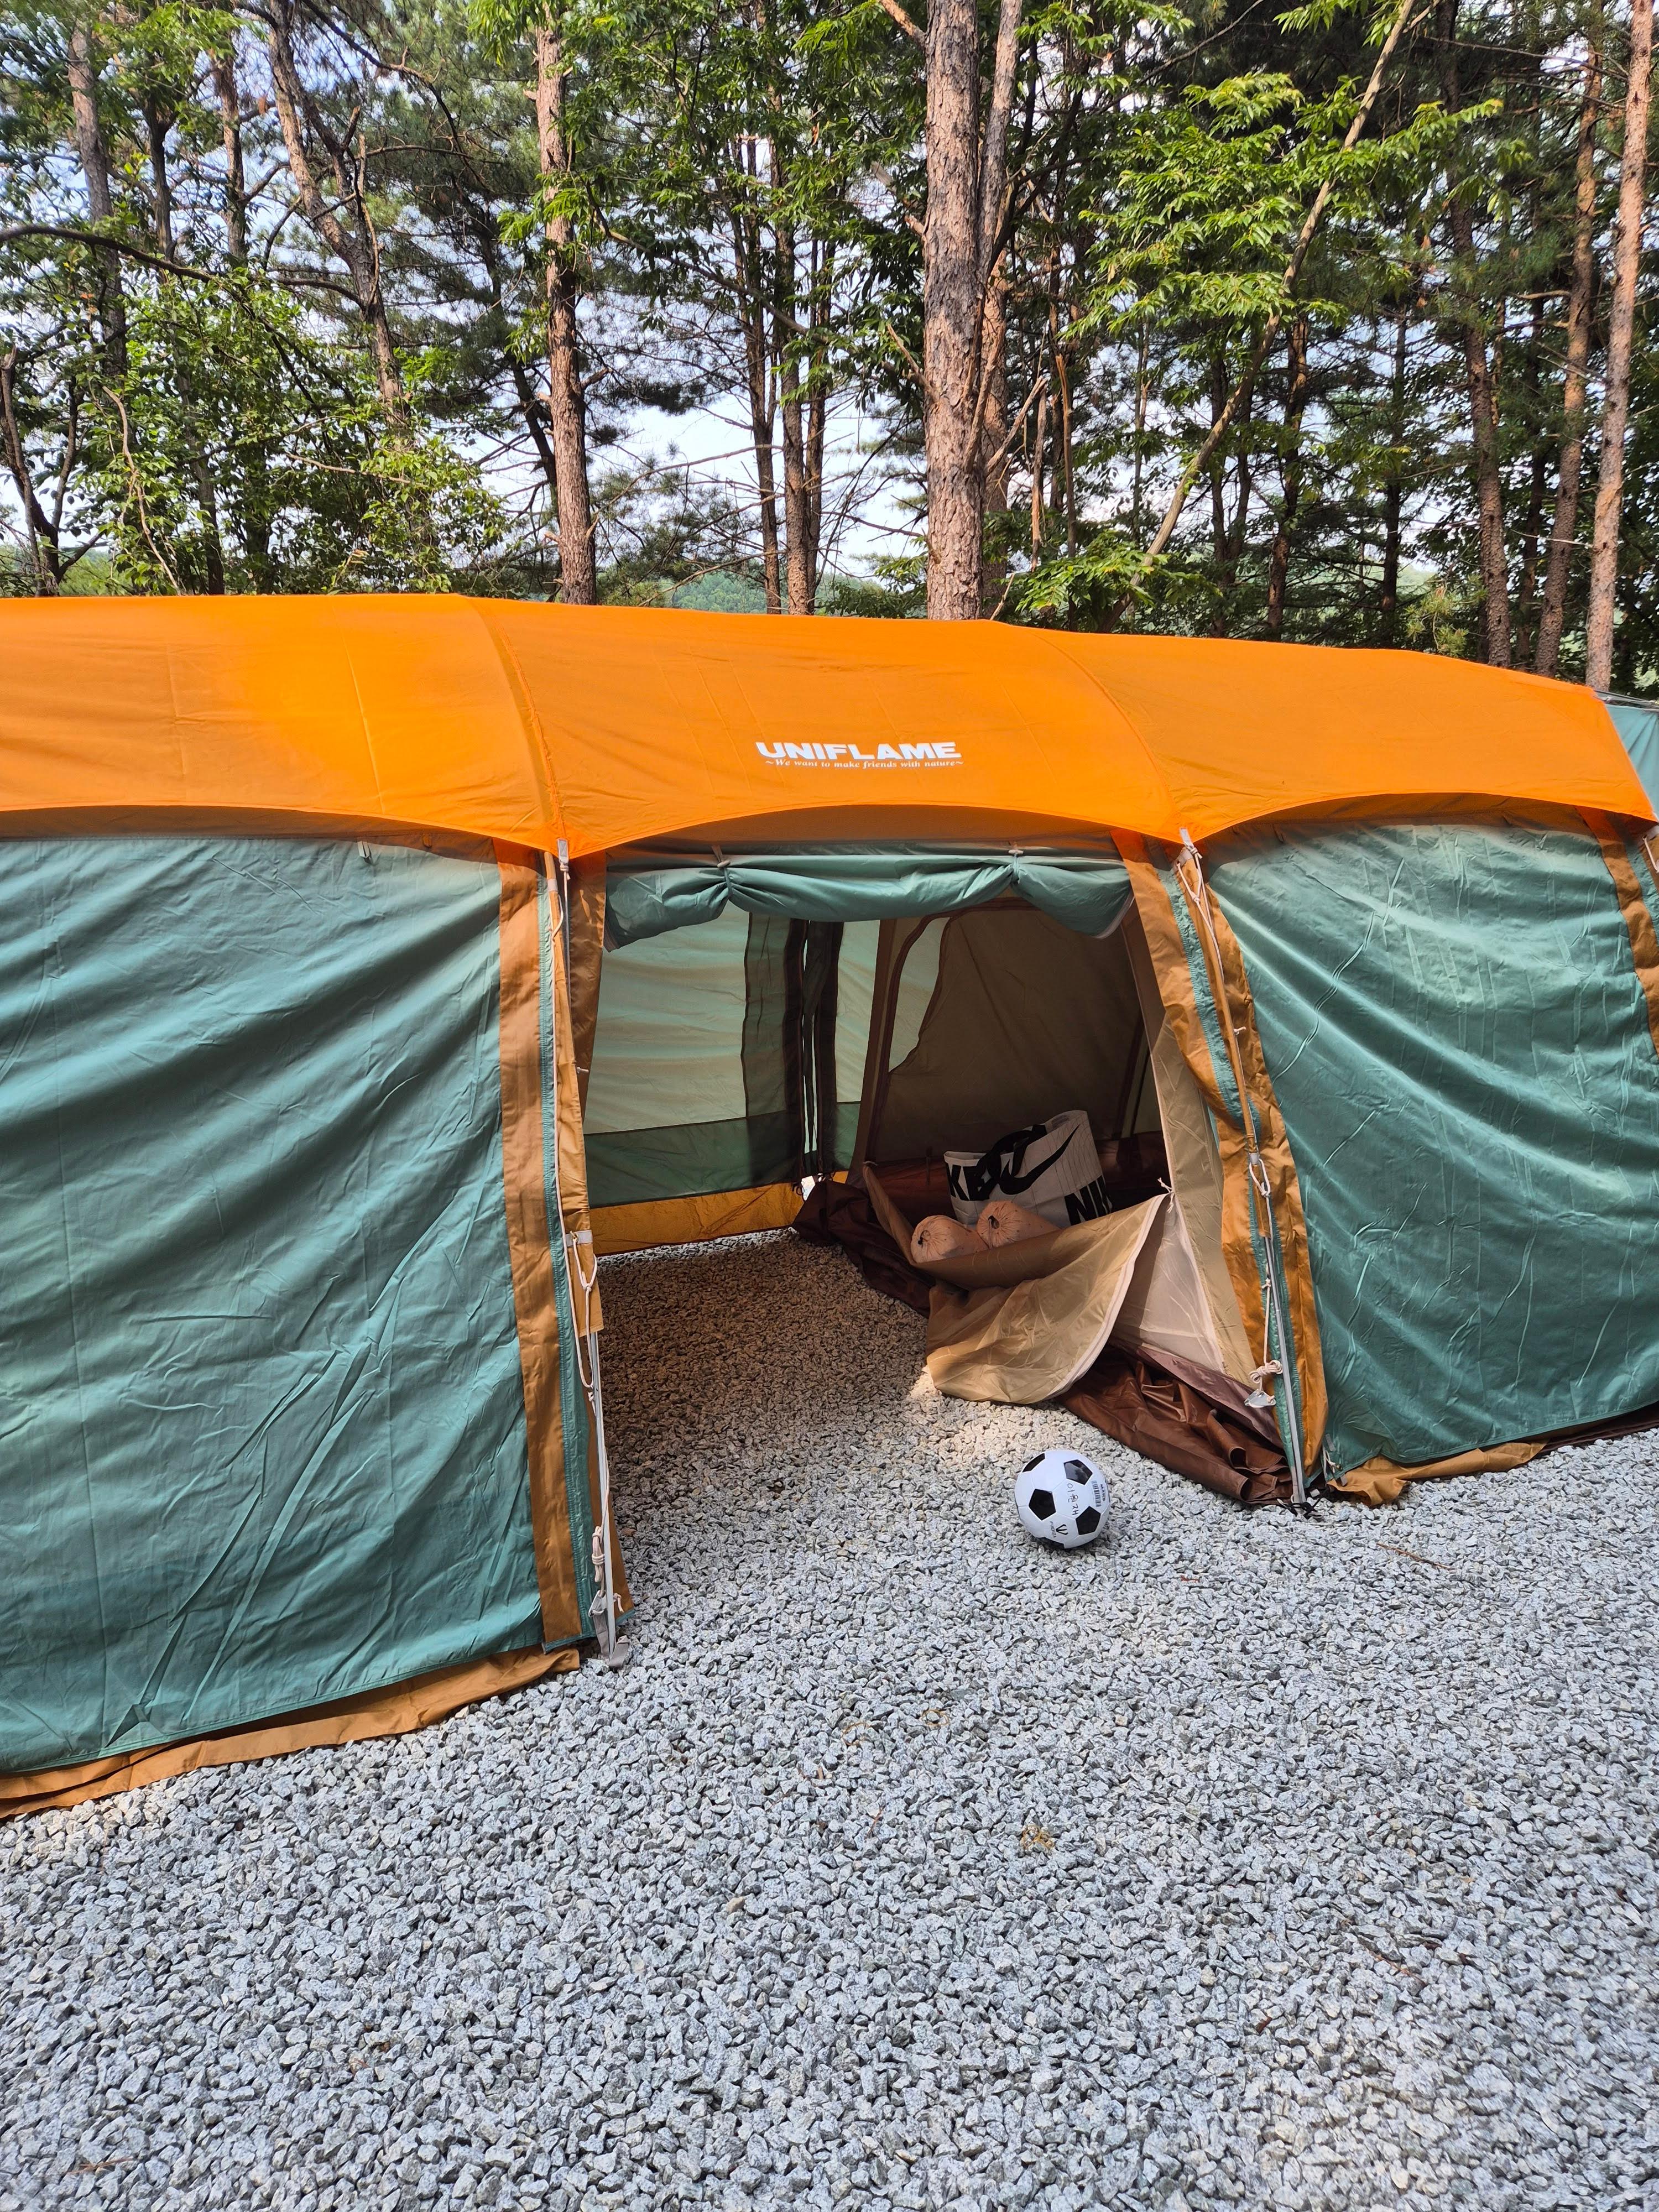
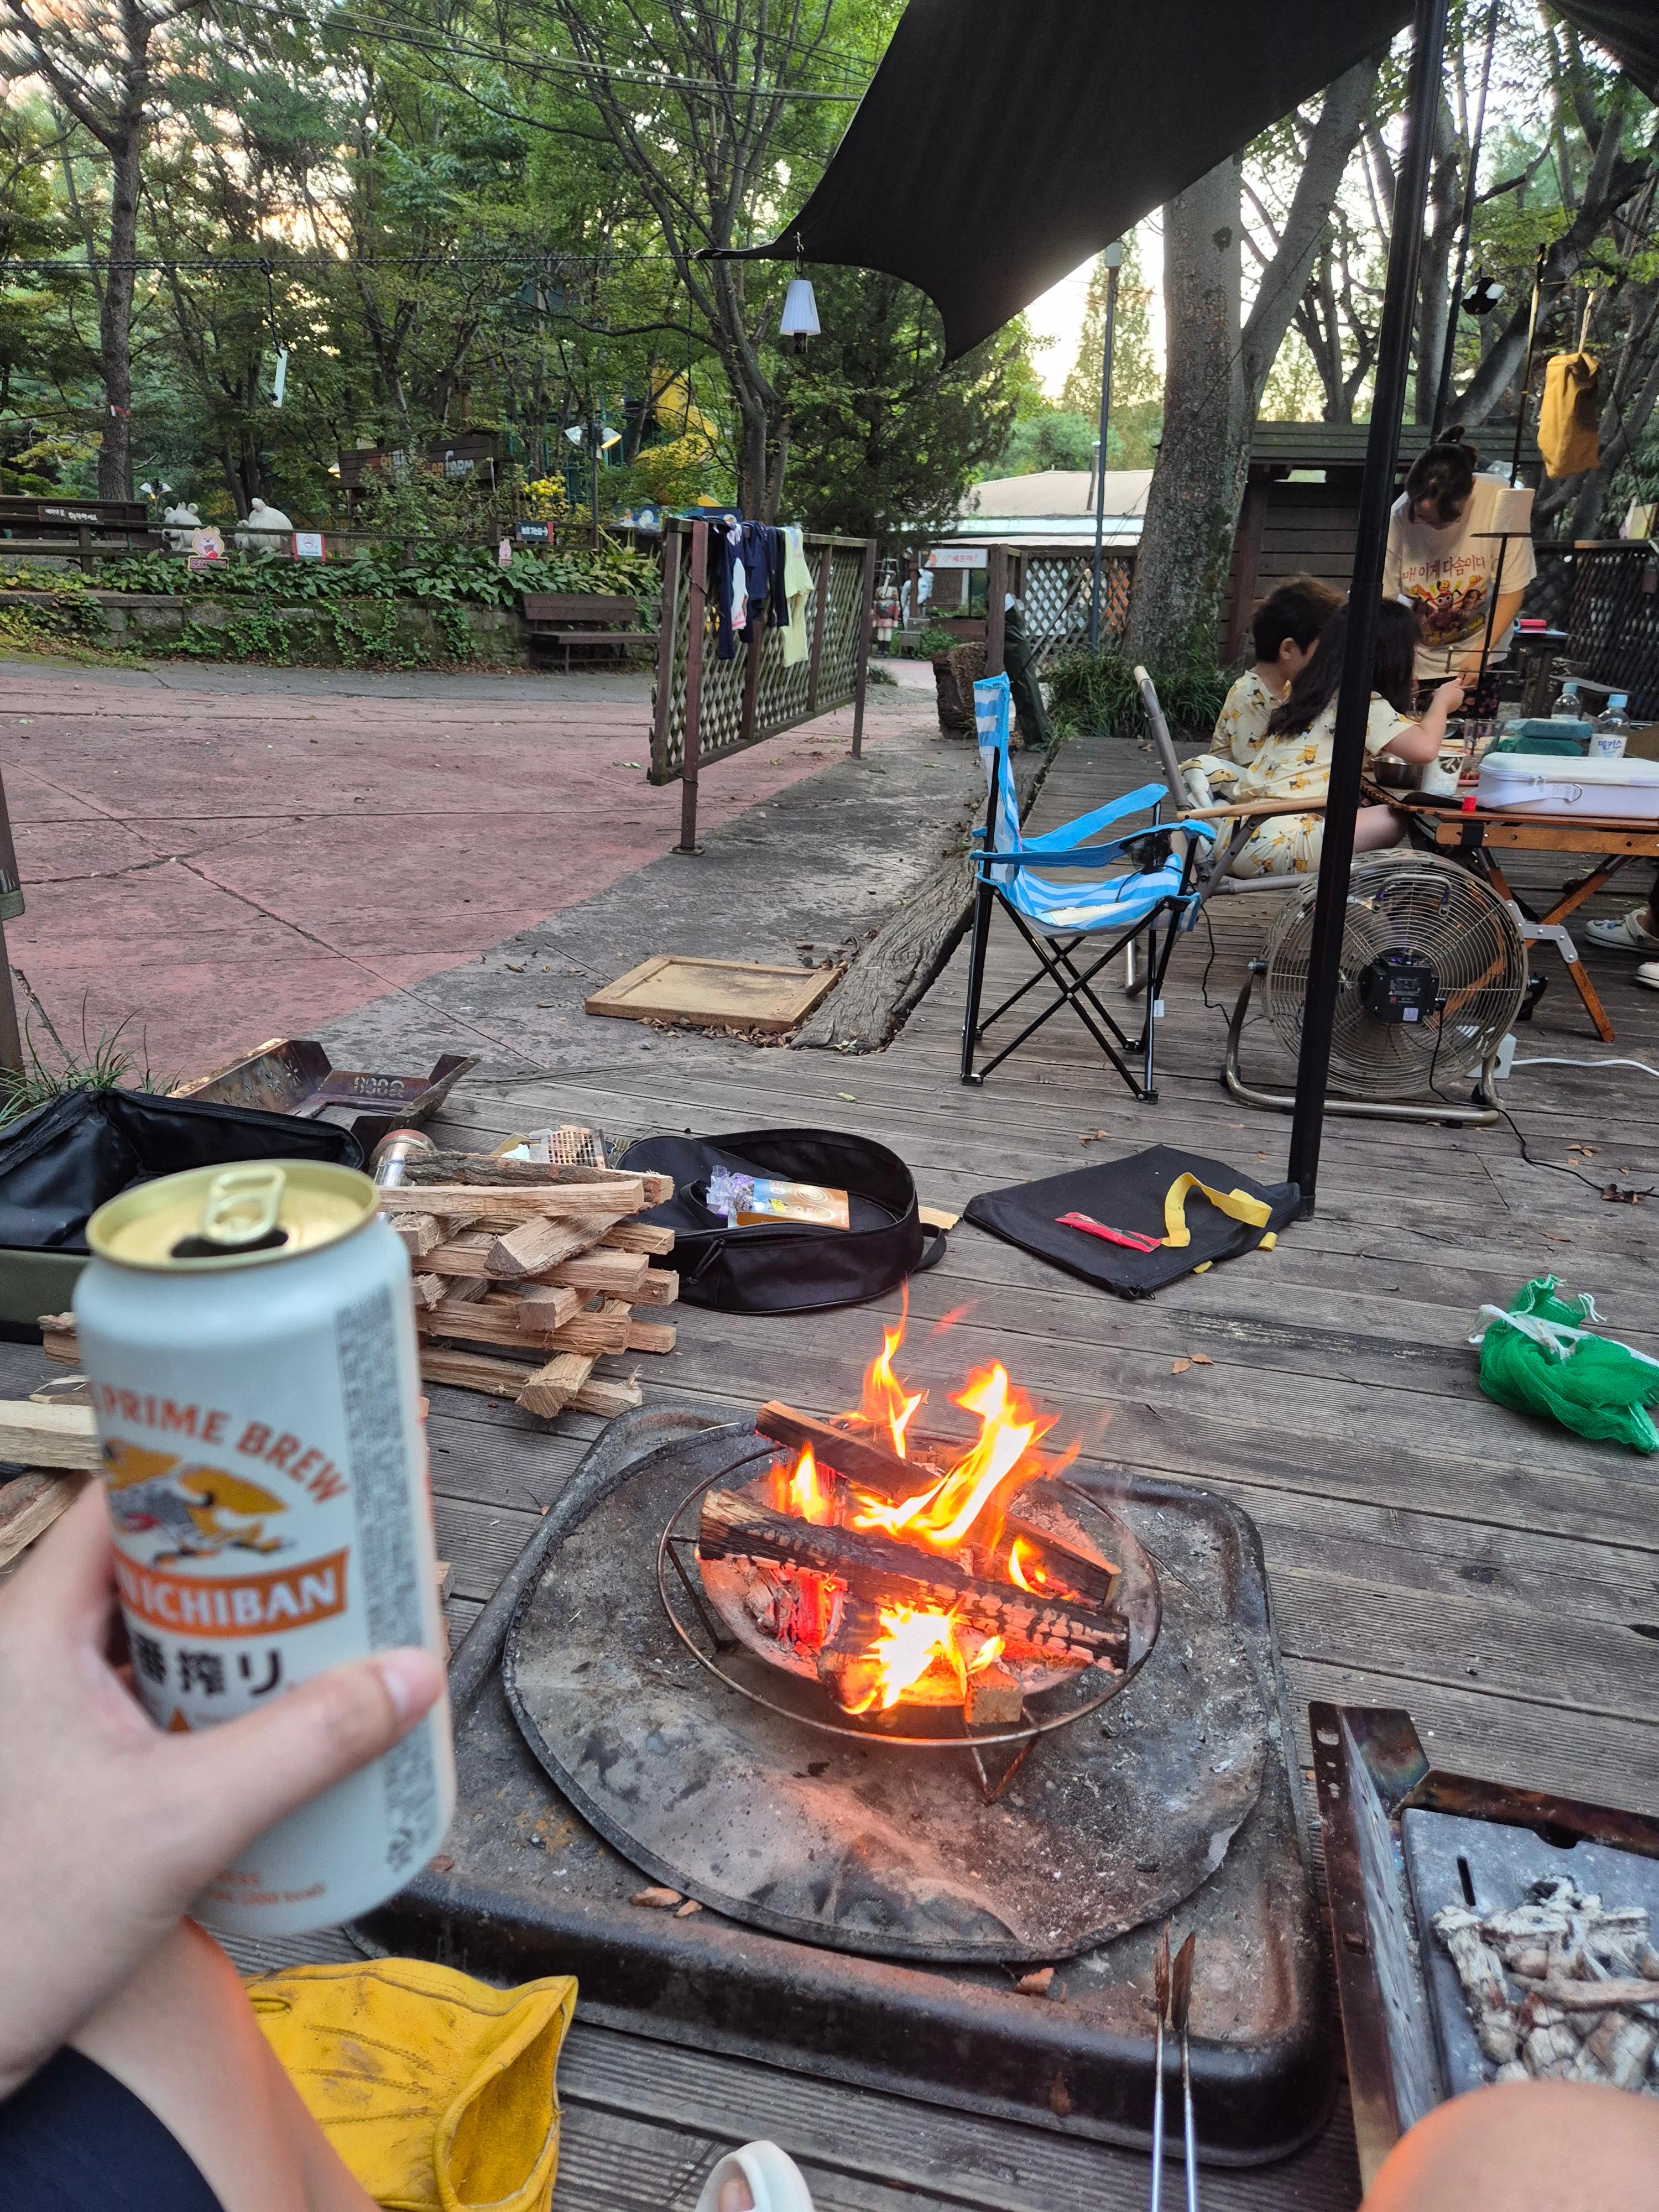
3월쯤이었다. 캠핑을 시작해볼까 고민만 하던 시기에 먼저 캠핑을 시작한 가족들에게 제대로 된(?) 접캠을 받게 됐다.

처음에는 그냥 따라가서 먹고, 자고, 놀다 오는 정도였다. 텐트도 이미 쳐져 있고, 테이블도 있고, 의자도 있고, 먹을 것도 다 준비되어 있으니 나는 사실상 아무것도 하지 않는 캠핑 인턴이었다.

처음에는 캠핑이 뭐가 그렇게 좋은가 싶었는데 몇 번 따라다니다 보니 조금씩 느낌이 달라졌다. 밖에서 먹는 밥이 괜히 더 맛있고, 밤에 불멍하면서 이야기하는 시간도 좋고, 아침에 텐트 밖으로 나왔을 때 공기마저 기분 좋게 느껴졌다.

그러다 어느 순간부터 남의 장비가 눈에 들어오기 시작했다.

저 의자는 편해 보이고, 저 테이블은 좋아 보이고, 랜턴도 하나 있으면 좋을 것 같고, 텐트도 슬슬 내 것이 있었으면 좋겠다는 생각이 들었다.

그렇게 하나씩 장비를 사기 시작했다.

캠핑을 해본 사람들은 알겠지만 ‘이제 거의 다 샀다’는 말은 별 의미가 없다.

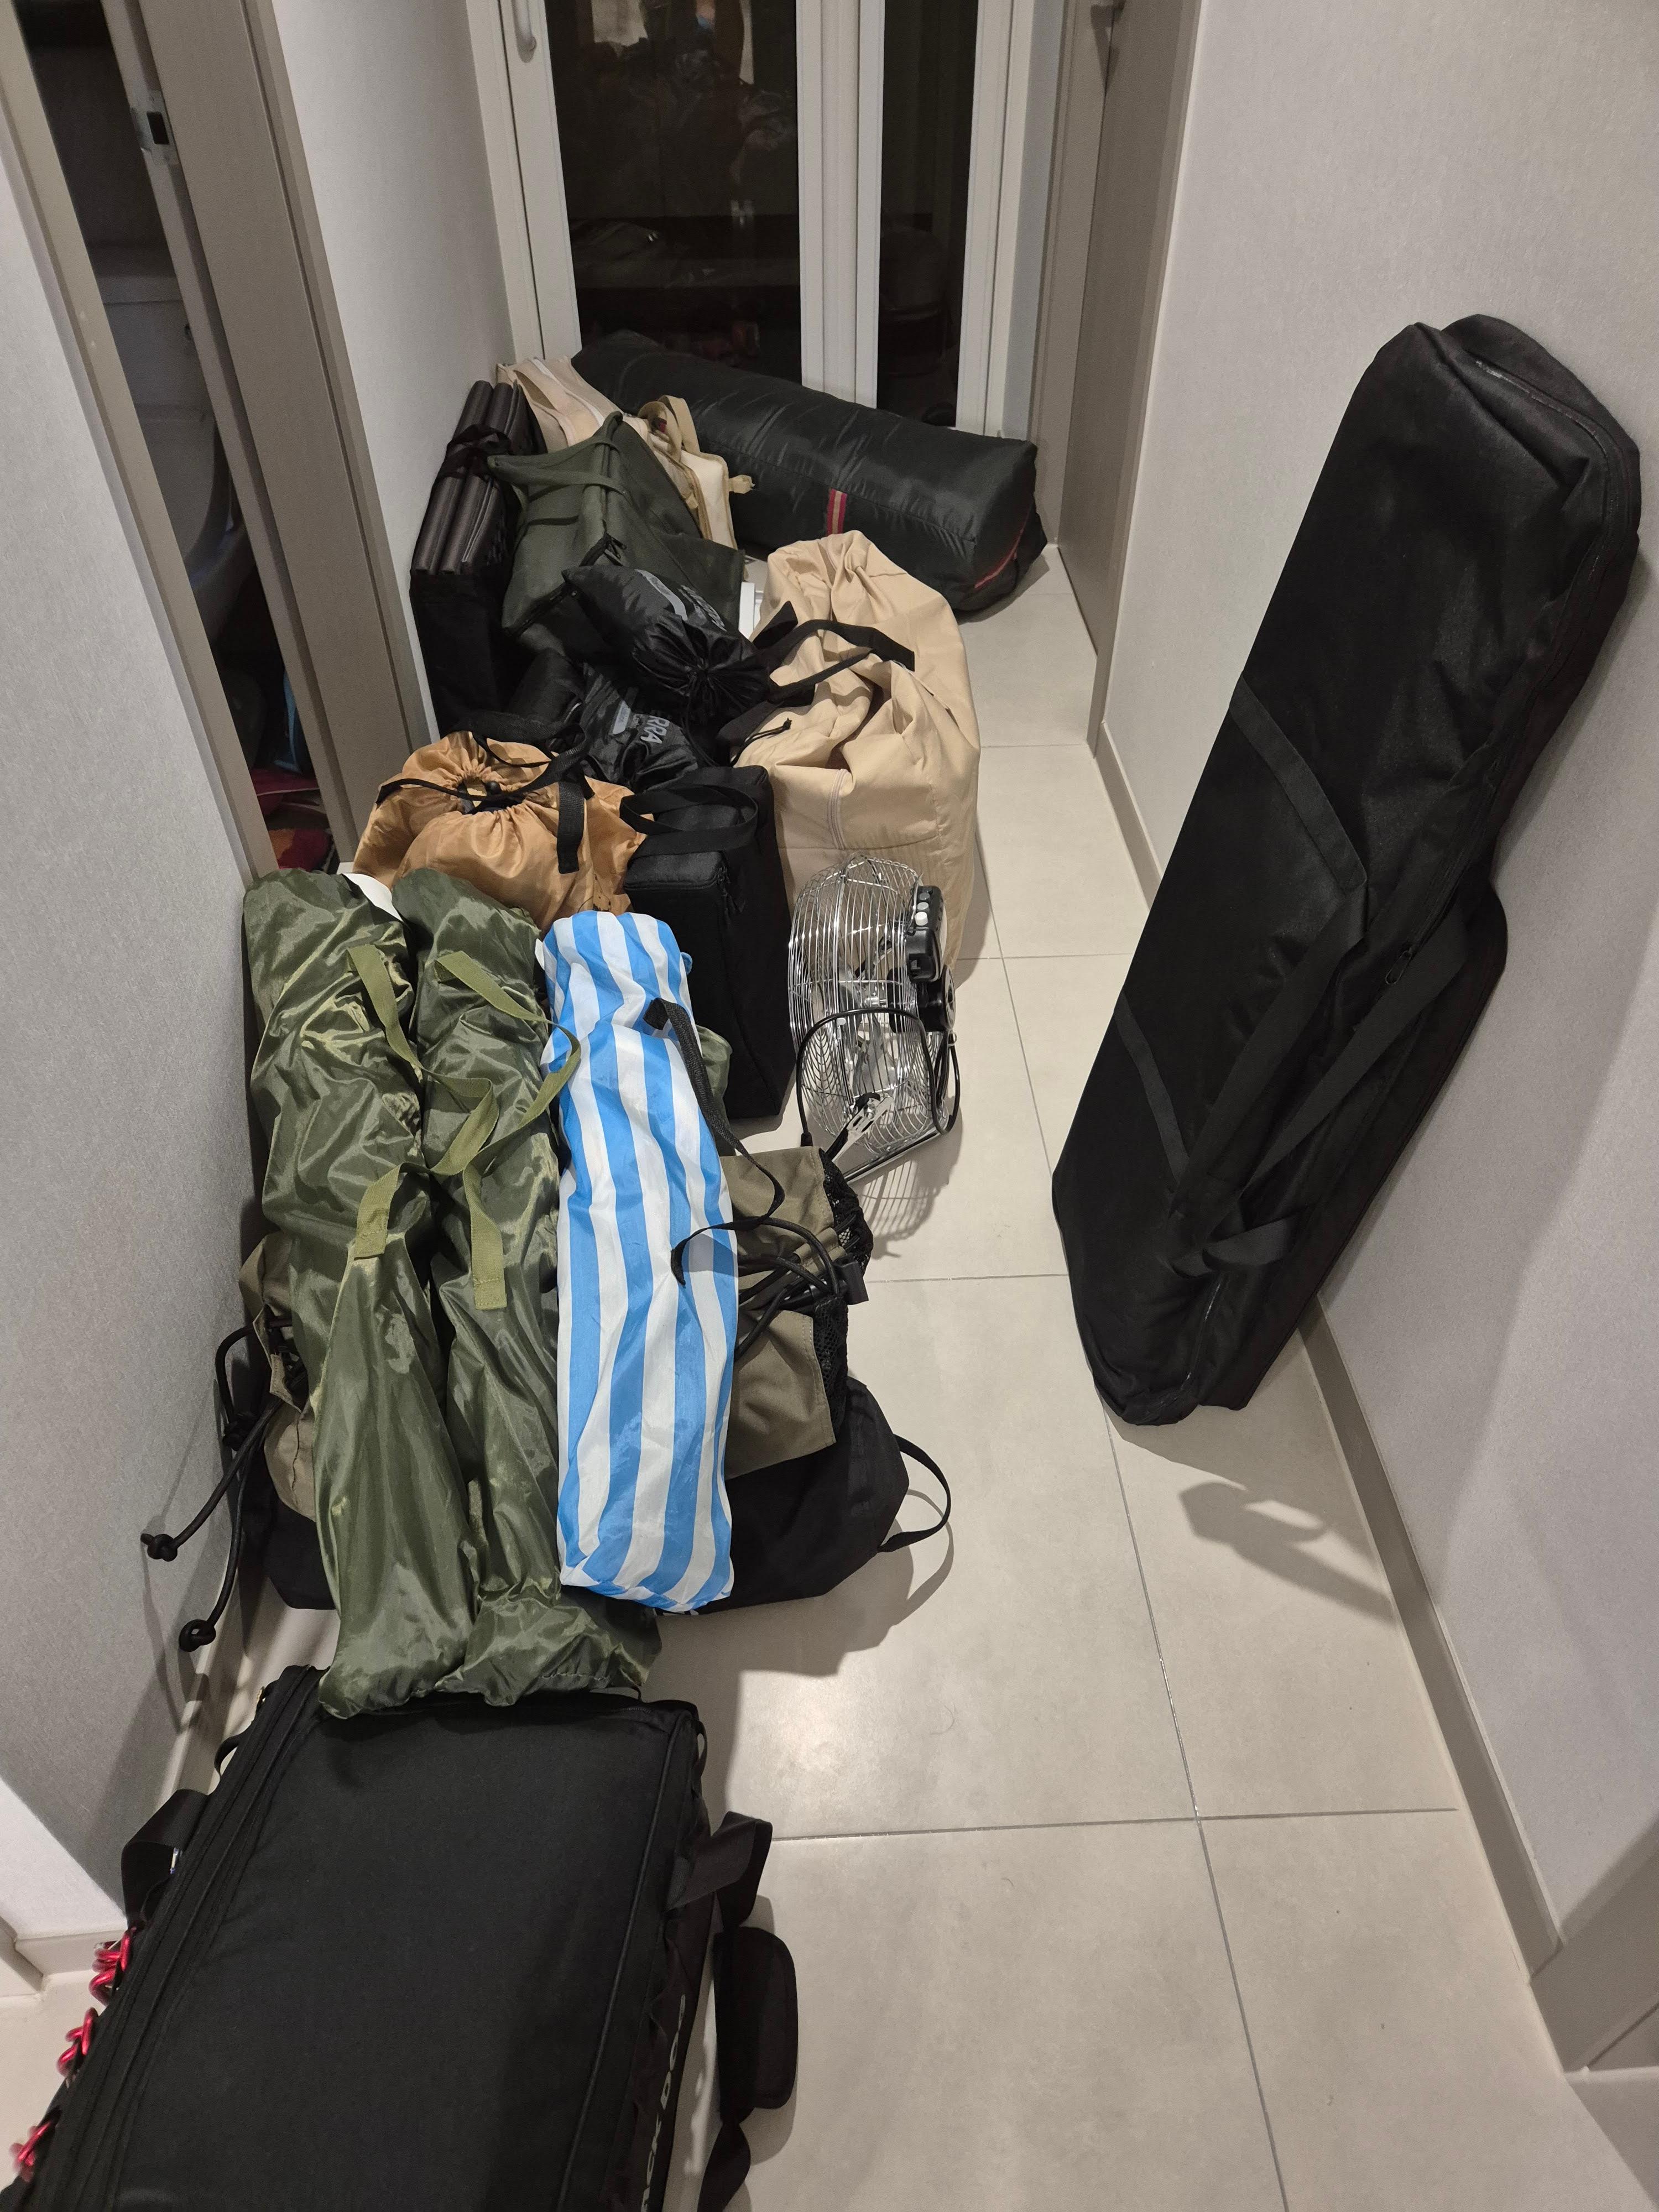
분명 처음에는 텐트와 의자 정도면 될 줄 알았는데, 테이블이 생기고, 랜턴이 생기고, 수납박스가 생기고, 침구가 생기고, 주방용품이 생기고….

하나를 사면 또 하나가 필요해졌다.

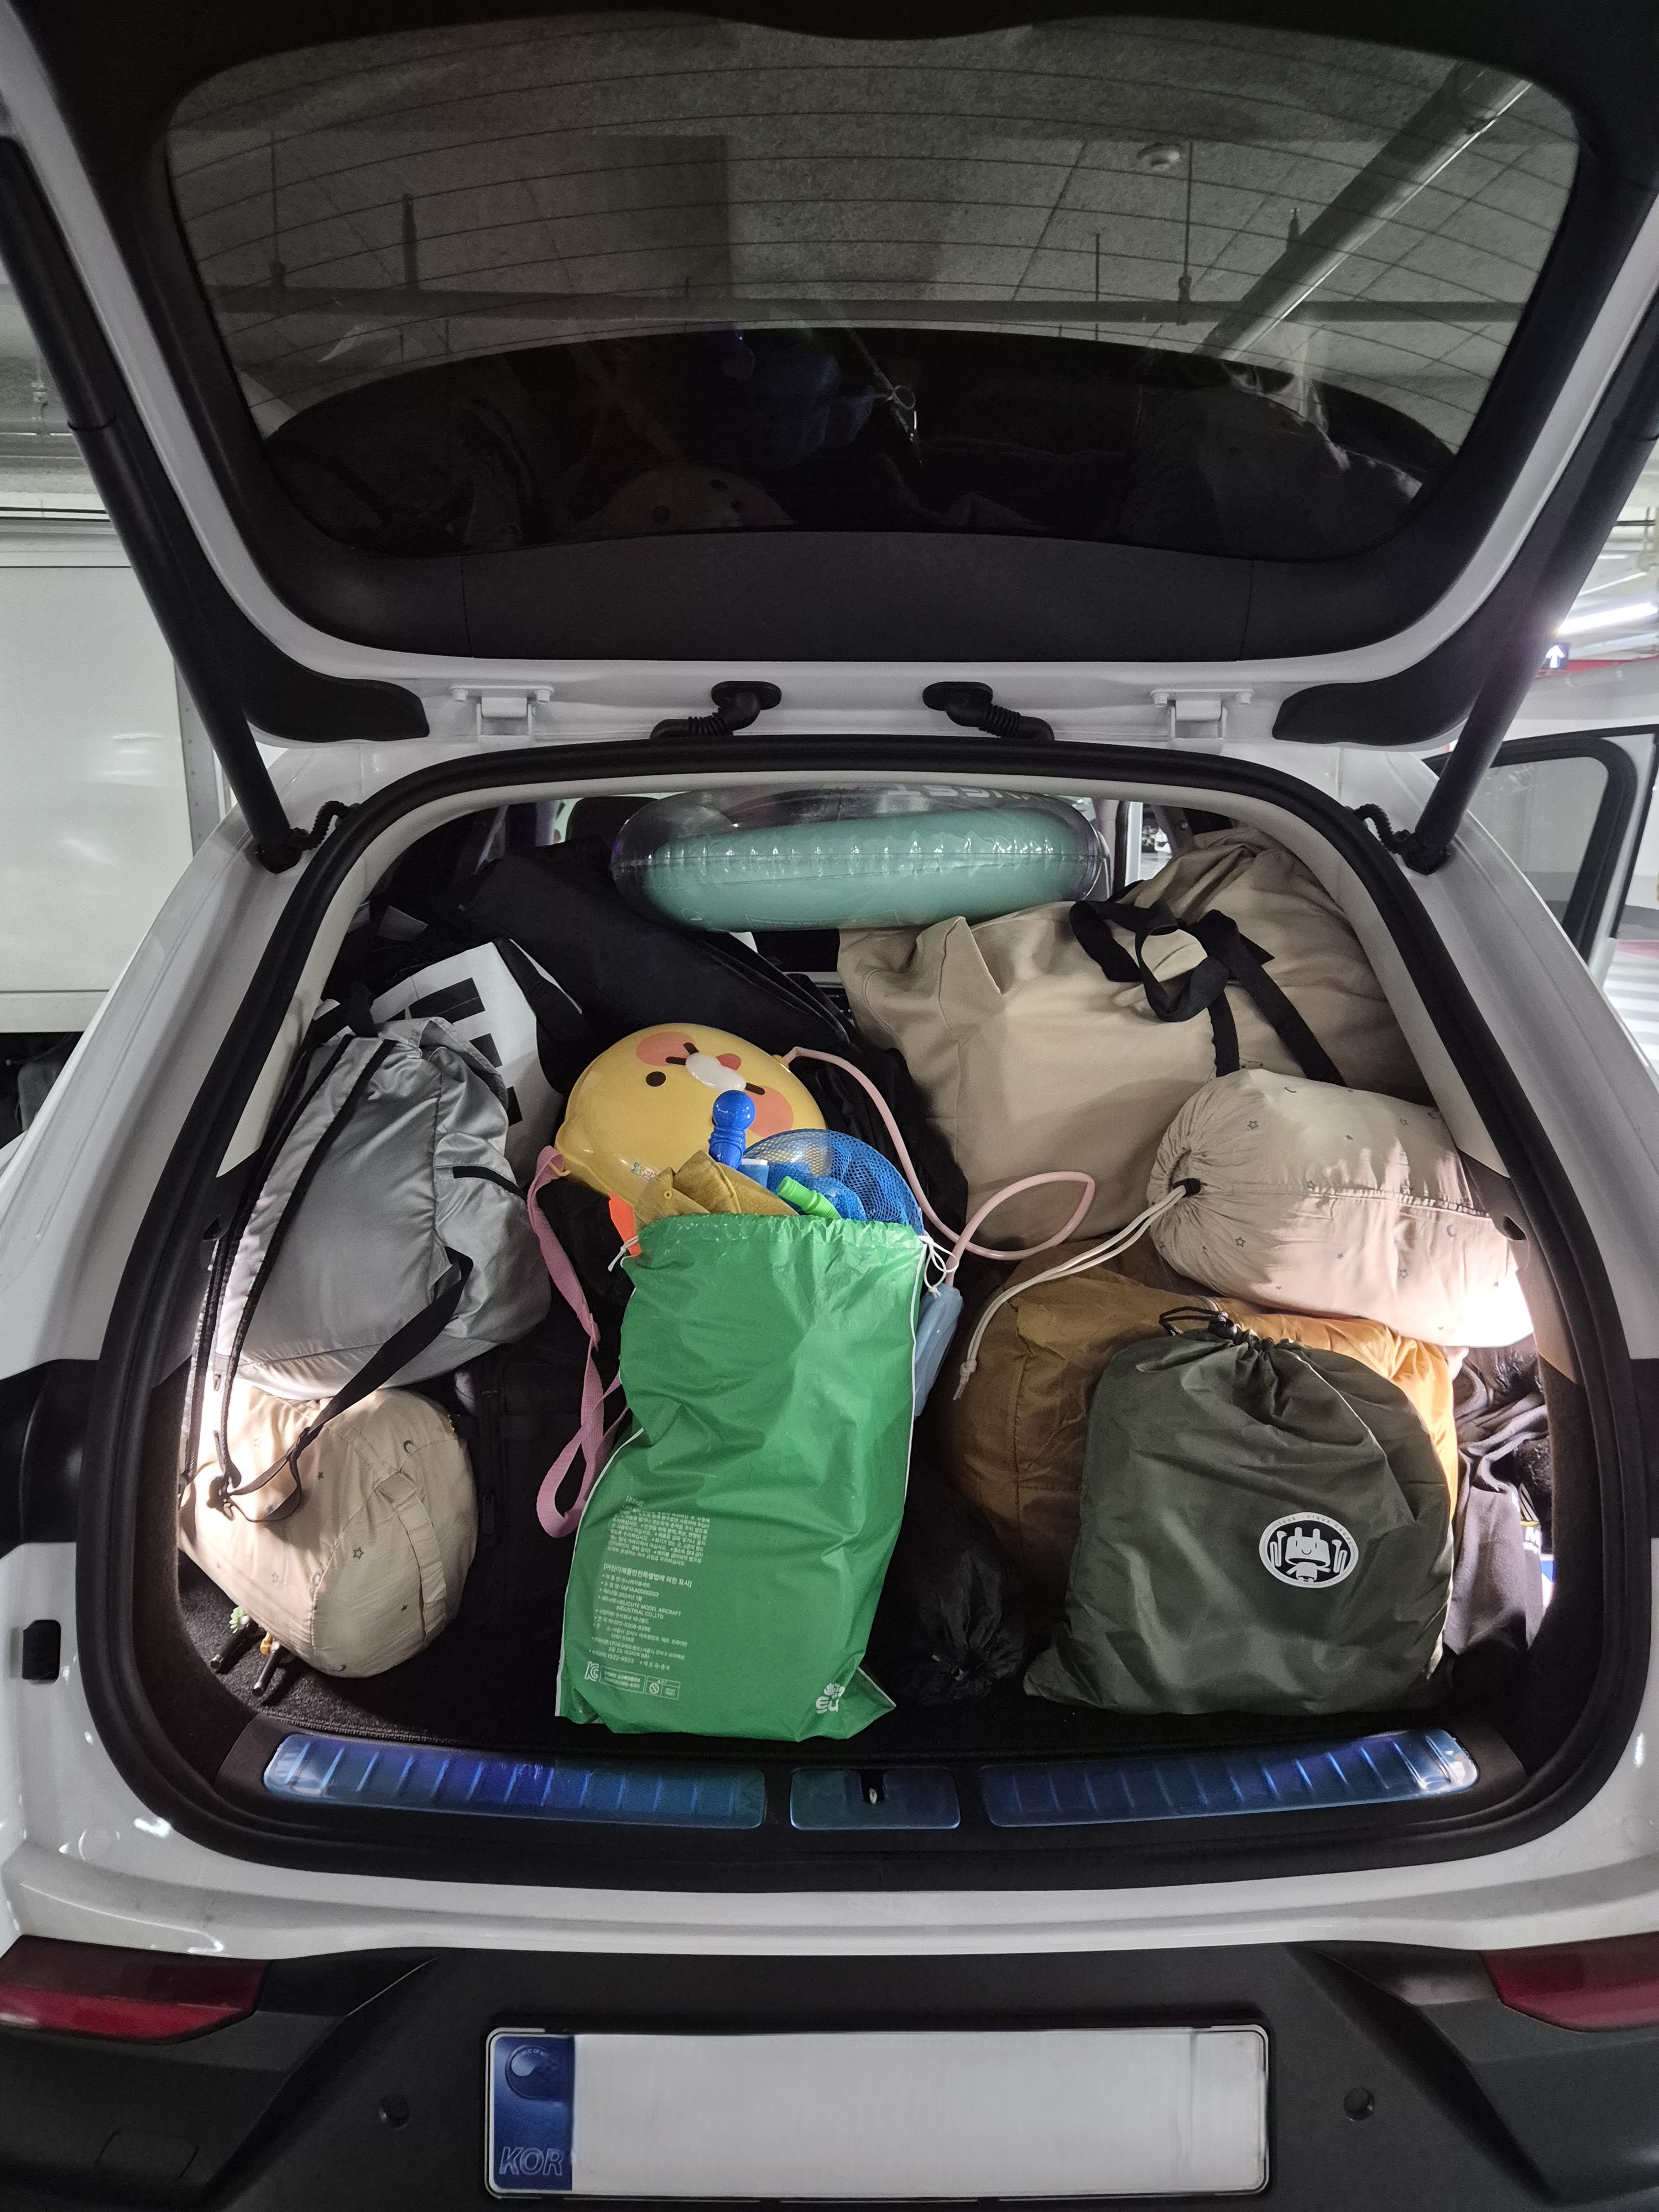
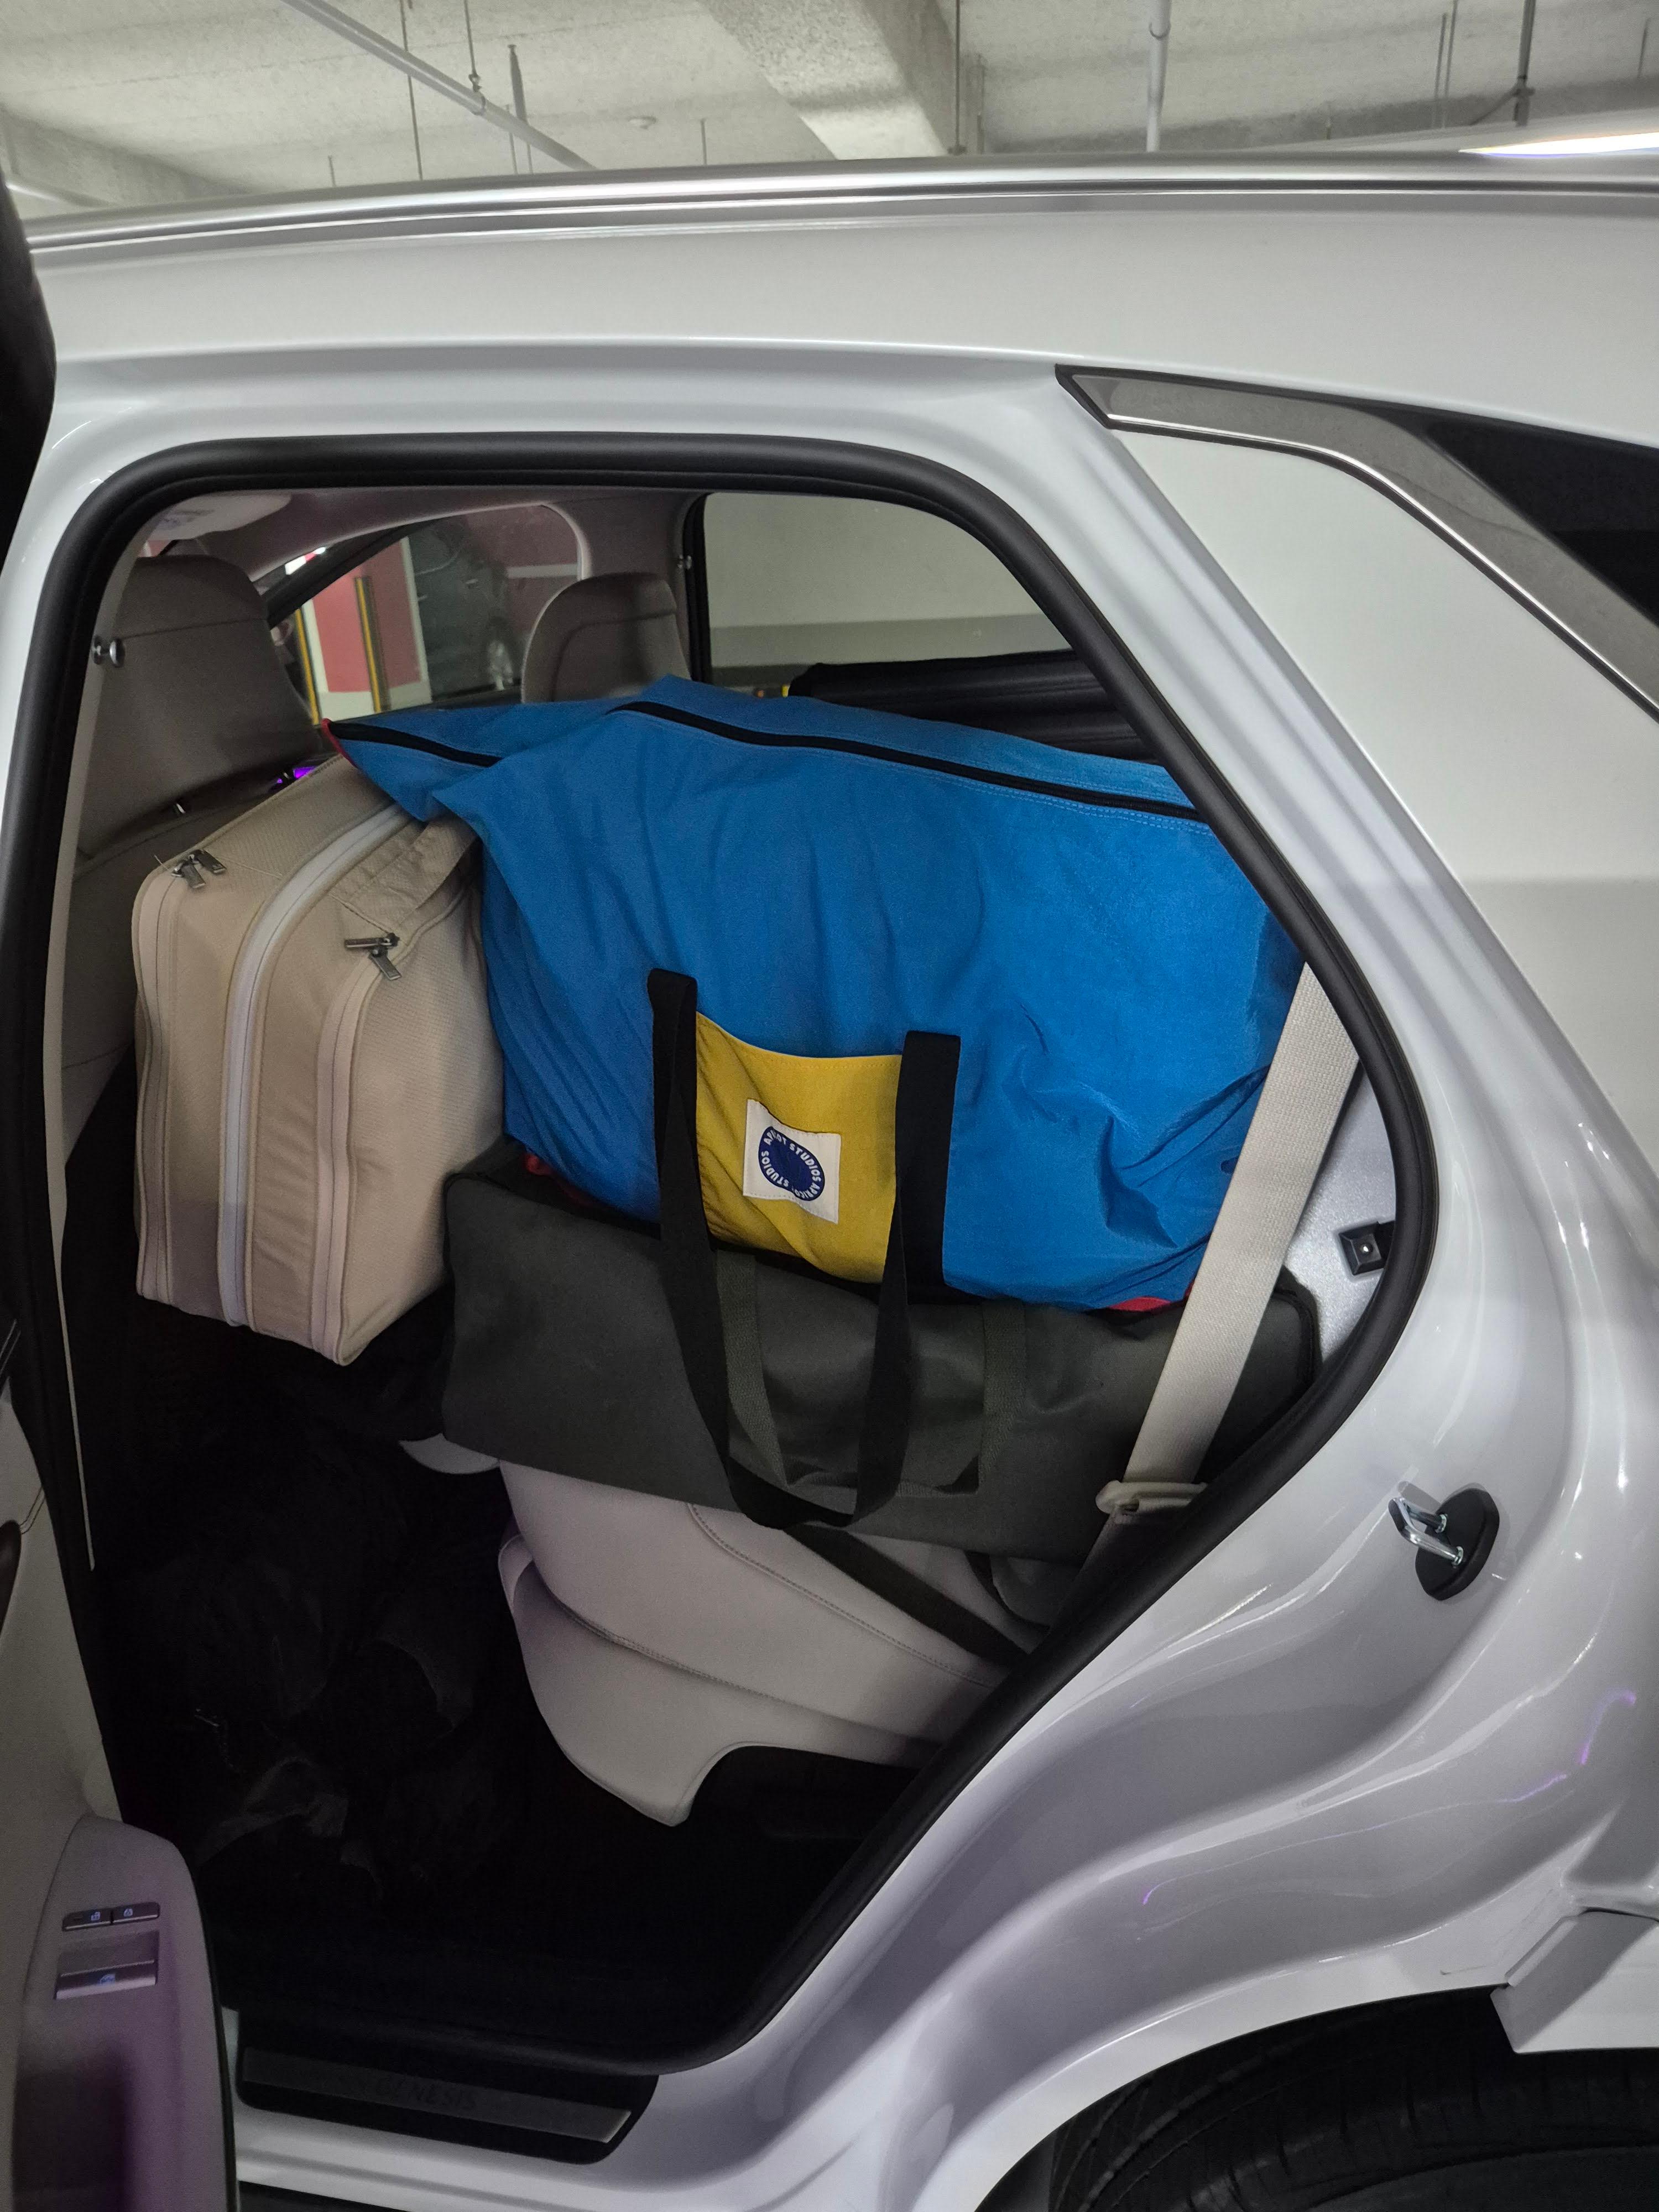
그리고 어느 순간 자동차 트렁크를 열어보니 이런 모습이 되어 있었다.

이게 정말 우리가 며칠 놀러 가기 위해 필요한 짐이 맞나 싶을 정도로 차가 꽉 찼다.

처음 접캠을 갔을 때 몸만 따라갔던 나를 생각하면 정말 많이 발전했다. 이제는 누군가가 차에 실린 짐을 보면 “이 사람 캠핑 좀 하는구나” 정도는 생각하지 않을까 싶다.

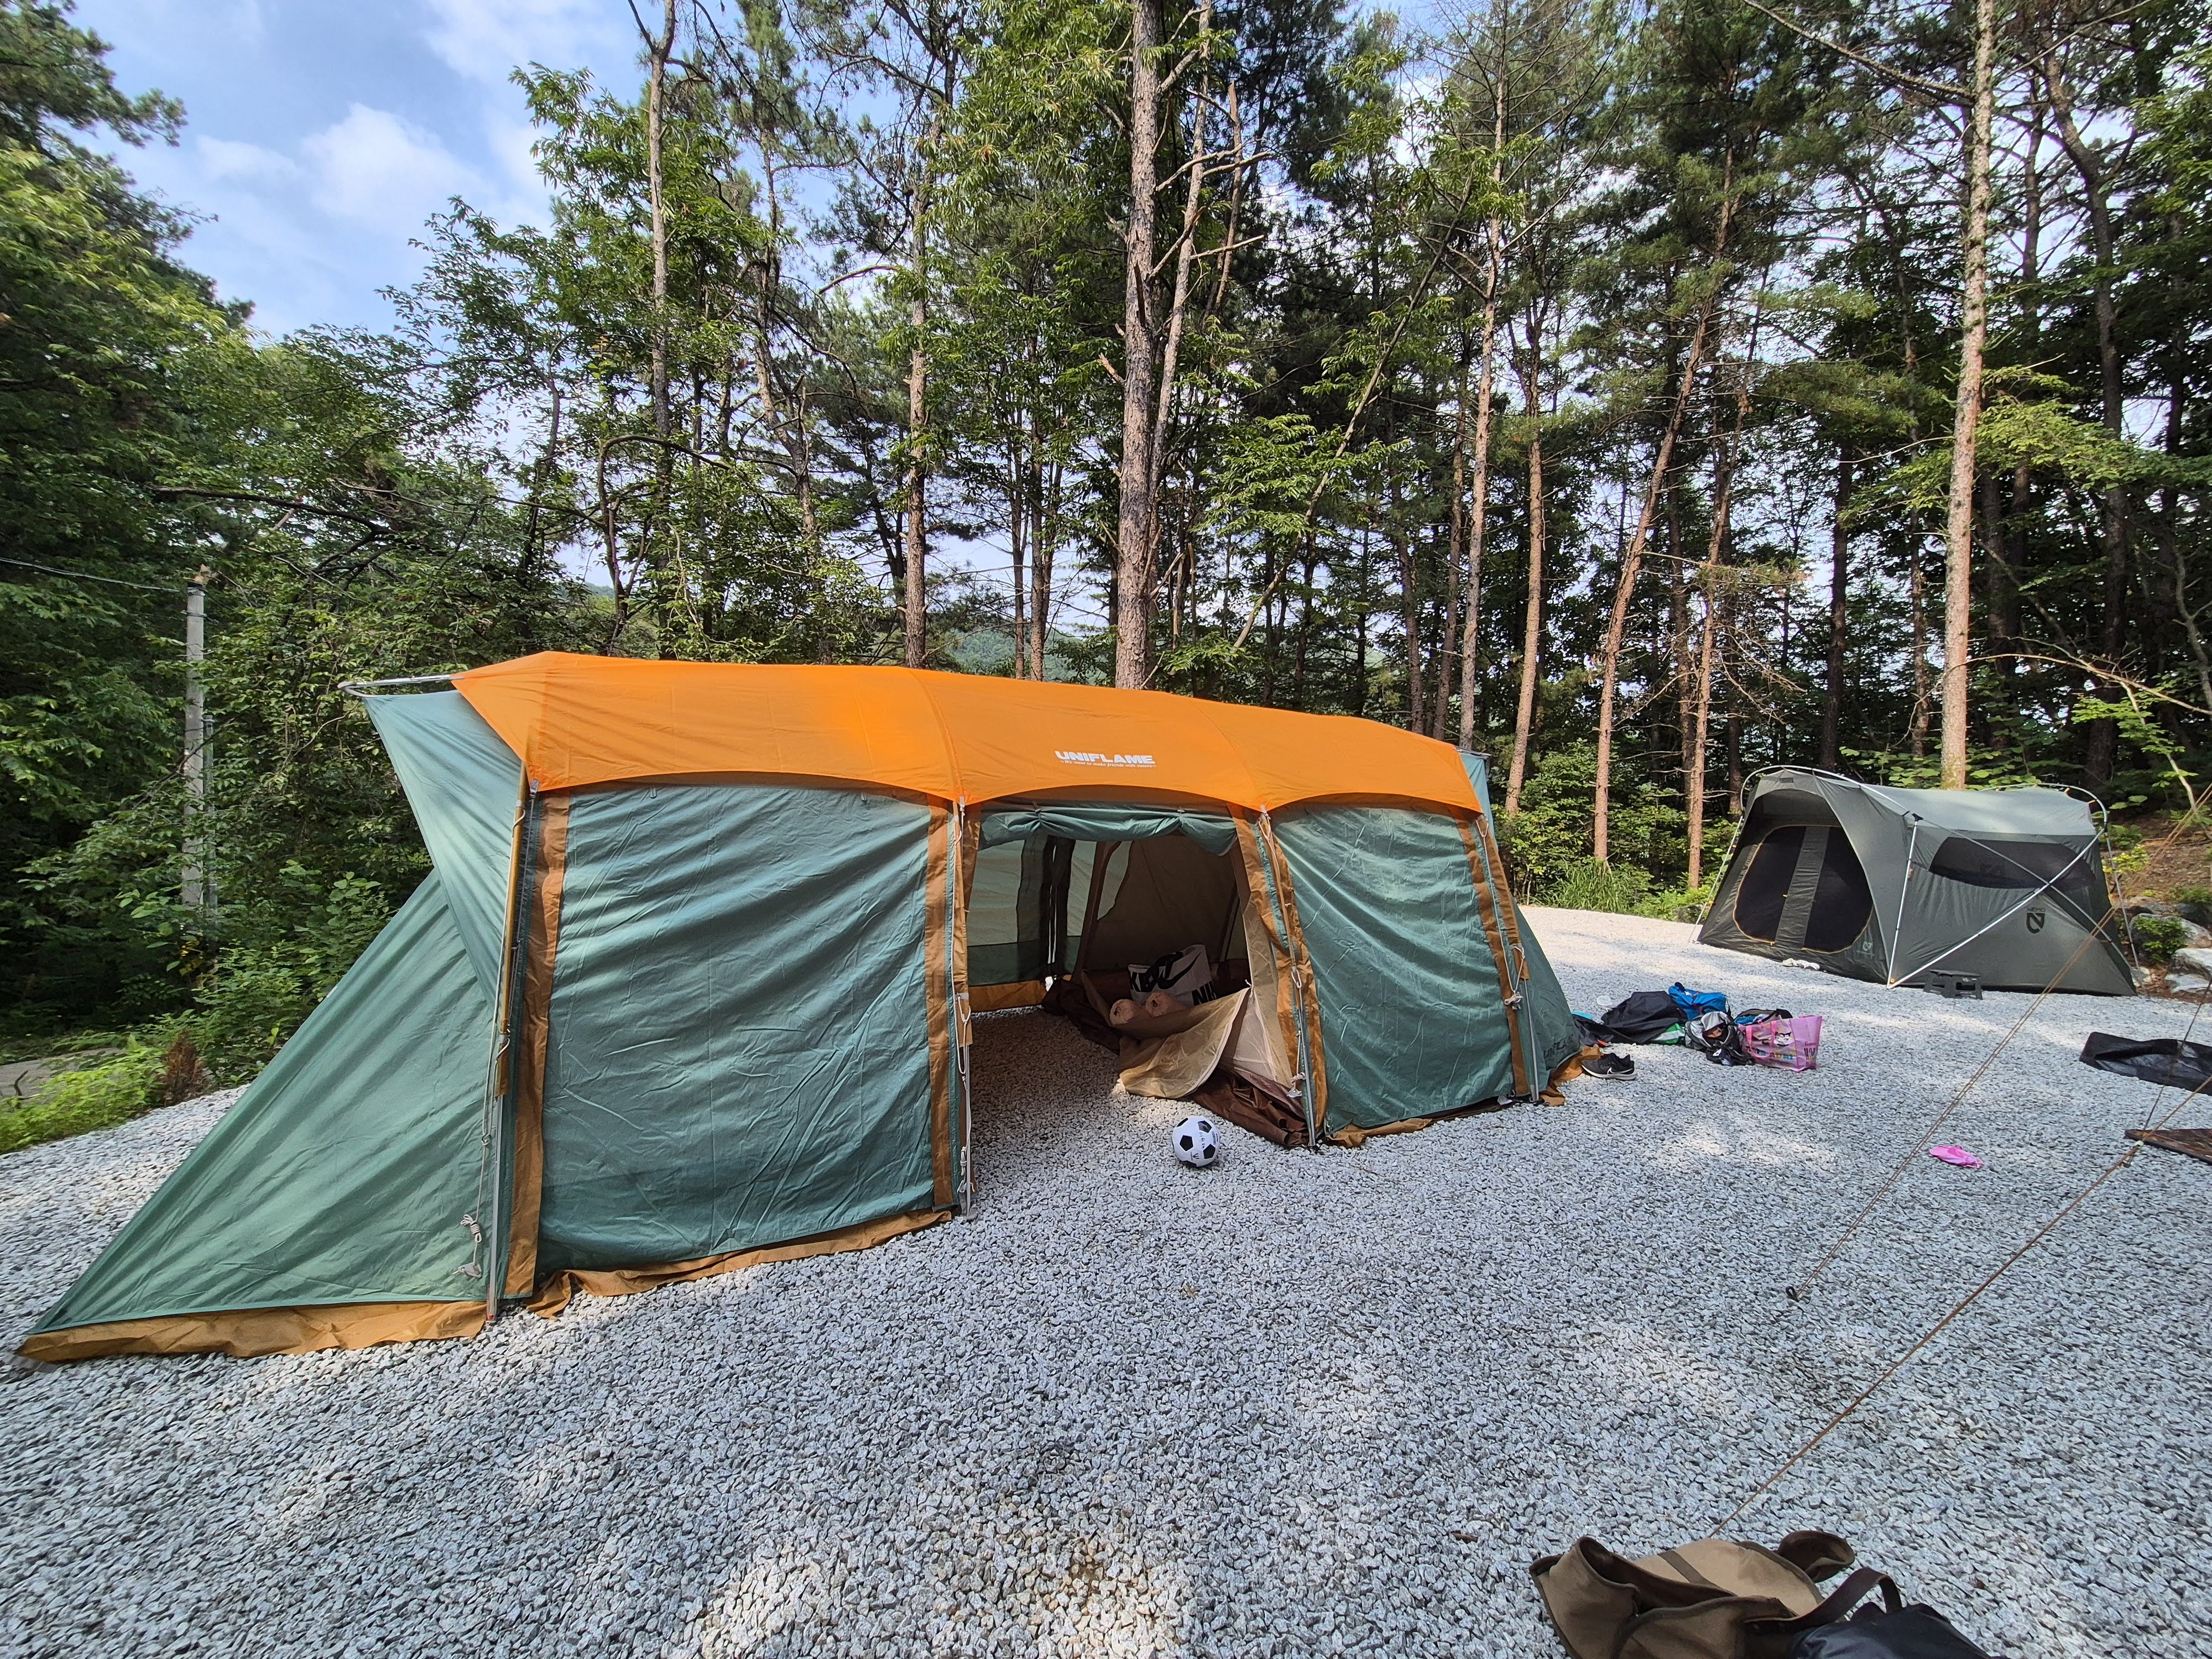
그리고 얼마 전, 나를 캠핑의 세계로 끌어들였던 가족들과 또 한 번 캠핑을 다녀왔다.

처음에는 이것저것 배우면서 따라다니기 바빴는데 이번에는 내 장비를 직접 챙기고, 자리를 만들고, 먹을 것도 준비하면서 캠핑을 즐겼다.

그 모습을 보면서 문득 이런 생각이 들었다.

이제 캠핑 인턴 정도는 수료해도 되지 않을까?

3월부터 시작된 캠핑 인턴 생활은 이렇게 일단 마무리됐다.

물론 아직 모르는 것도 많고 사고 싶은 장비도 계속 생기겠지만, 이제는 누군가에게 접캠을 받으러 가는 사람이 아니라 내가 직접 캠핑을 준비해서 즐길 수 있는 정도는 된 것 같다.

그동안 잘 먹이고, 잘 재우고, 캠핑의 재미를 제대로 알려준 선배 캠퍼 가족들에게 감사하며.

캠핑 인턴, 수료했습니다.

이제 다음 단계는 아마도…

장비 그만 사기일 것 같다.

아마 쉽지는 않겠지만.

반응형

오늘은 별다른 정보도 없고, 그냥 우리 집 고양이 자랑이나 좀 해보려고 한다.

블로그를 쓰다 보면 뭔가 도움이 되는 이야기를 해야 할 것 같고, 검색되는 글을 써야 할 것 같은 생각이 드는데 가끔은 이런 글도 하나쯤 있어야 하지 않을까 싶다. 어차피 내 블로그니까.

사진첩을 열어보면 고양이 사진이 정말 많다. 분명 비슷한 자세로 자고 있고, 비슷한 표정을 하고 있는데 볼 때마다 또 찍는다. 찍을 때는 항상 오늘은 좀 다르다고 생각한다. 나중에 몰아서 보면 거의 비슷한데도 이상하게 삭제는 못 하겠다.

보고 있으면 가끔 부럽기도 하다. 나는 아침부터 이것저것 신경 쓰면서 살고 있는데 이 녀석의 하루는 대체로 자고, 밥 먹고, 창밖 좀 보고, 다시 자는 것으로 끝난다. 그런데 집에서는 나보다 대접도 좋다.

고양이를 키우기 전에는 굉장히 우아한 동물이라고 생각했는데 같이 살아보면 꼭 그렇지만도 않다.

아주 평온하다. 가까이 가서 사진을 찍으면 가끔 눈을 살짝 뜨는데 그 표정이 꼭 귀찮게 왜 그러냐고 하는 것 같다.

평소에는 불러도 잘 오지 않고 관심 없는 척하면서도 어느 순간 근처에 와 있다.

안아달라고 하는 것도 아니고, 특별히 애교를 부리는 것도 아닌데 그냥 가까이에 있다. 그런 걸 보면 관심이 없는 게 아니라 관심 없는 척하는 게 아닐까 싶다.


사실 고양이를 키운다고 해서 매일 특별한 일이 생기는 건 아니다. 집에 들어왔을 때 한번 쳐다봐주고, 소파 한쪽에서 자고 있고, 가끔 옆에 와서 몸을 붙이고 있는 정도다. 그런데 그런 별것 아닌 장면들이 생각보다 좋다.


결론은 별거 없다.

그냥 우리 집 고양이가 귀엽다는 이야기다.

몇 년 뒤 이 글을 다시 봤을 때 이때도 참 귀여웠구나 하고 한번 웃을 수 있으면 그걸로 충분할 것 같다. 사진첩에는 아직 올리지 않은 사진이 한참 남아 있으니 아마 고양이 자랑은 앞으로도 계속될 것 같다.

반응형

Java 개발을 하다 보면 한 번쯤 이런 이야기를 듣는다.

"Stream 쓰면 느려요. 그냥 for문 쓰세요."

반대로 이런 이야기도 있다.

"요즘 누가 for문 써요? Stream이 훨씬 깔끔하죠."

둘 중 어느 말이 맞을까?

결론부터 말하면 둘 다 맞을 수도 있고, 둘 다 틀릴 수도 있다.

나는 Java로 오랫동안 개발하면서 for문도 정말 많이 사용했고, Java 8 이후에는 Stream 역시 자주 사용하고 있다.

지금은 어느 한쪽을 고집하지 않는다.

내가 중요하게 보는 것은

"어떤 코드가 지금 이 로직을 가장 명확하게 표현하는가?"

이다.

물론 성능이 정말 중요한 코드라면 이야기가 달라진다.

이번 글에서는 Stream과 for문의 단순 문법 비교가 아니라, 실무에서 어떤 기준으로 둘 중 하나를 선택하는지 정리해보려고 한다.


먼저 결론부터

내 기준은 대략 이렇다.

Stream을 주로 사용하는 경우

  • Collection을 필터링할 때
  • 데이터를 다른 형태로 변환할 때
  • 특정 값을 찾을 때
  • 합계나 평균 등을 계산할 때
  • grouping이나 mapping처럼 데이터 가공 목적이 명확할 때
  • 코드가 한눈에 읽힐 때

for문을 사용하는 경우

  • 반복문 안에서 여러 상태를 변경해야 할 때
  • 복잡한 분기문이 들어갈 때
  • 중간에 continue나 break가 많이 필요할 때
  • 디버깅이 중요한 복잡한 비즈니스 로직일 때
  • 극단적으로 성능이 중요한 반복 처리일 때
  • Stream으로 작성했더니 오히려 읽기 어려워질 때

결국 내 기준은

Stream = 데이터의 흐름

for = 처리 과정

에 가깝다.


1. Stream이 무조건 for문보다 느린가?

가장 많이 나오는 질문이다.

일반적인 순차 처리에서 단순 for문은 매우 직접적이다.

List<Order> paidOrders = new ArrayList<>();

for (Order order : orders) {
    if (order.isPaid()) {
        paidOrders.add(order);
    }
}

반면 Stream으로 작성하면 다음과 같다.

List<Order> paidOrders = orders.stream()
        .filter(Order::isPaid)
        .toList();

결과는 같다.

하지만 내부적으로 실행되는 방식은 다르다.

Stream은

Collection
 → Stream 생성
 → filter
 → terminal operation

이라는 파이프라인을 구성한다.

람다 호출이나 Stream 파이프라인 처리 등의 비용이 있기 때문에 아주 단순한 반복 작업에서 for문보다 Stream이 무조건 빠를 것이라고 기대하면 안 된다.

그렇다고

Stream은 느리니까 쓰면 안 된다.

라고 결론 내리는 것도 지나치다.

Oracle의 Stream API 자체가 중간 연산을 lazy하게 처리하도록 설계돼 있다. filter, map 같은 intermediate operation은 실제 데이터를 바로 처리하지 않고 terminal operation이 호출됐을 때 실행된다.

예를 들어

Order order = orders.stream()
        .filter(Order::isPaid)
        .findFirst()
        .orElse(null);

에서는 조건에 맞는 첫 번째 데이터를 찾으면 이후 모든 데이터를 반드시 끝까지 처리해야 하는 것은 아니다.

즉 Stream도 단순히

전체 데이터 → 전체 데이터 → 전체 데이터

식으로 매 단계마다 새로운 Collection을 만드는 구조는 아니다.


2. 그런데 웹 서비스에서 그 성능 차이가 정말 중요할까?

이게 내가 더 중요하게 보는 부분이다.

예를 들어 API 하나가 있다고 하자.

Controller
    ↓
Service
    ↓
Database
    ↓
외부 API
    ↓
Redis

전체 응답 시간이 200ms인데,

Collection 100개를 처리하는 for문과 Stream의 차이가 극히 작은 수준이라면?

그 차이를 줄이기 위해 코드 가독성을 포기하는 것이 과연 의미가 있을까?

대부분의 일반적인 웹 서비스에서는 Stream과 for문의 차이보다

  • 잘못된 SQL
  • N+1 Query
  • Index 부재
  • 외부 API 응답
  • 네트워크
  • 불필요한 DB 호출
  • 대량 객체 생성
  • 잘못된 캐싱

같은 부분이 훨씬 큰 성능 문제를 만든다.

그래서 나는 일반적인 비즈니스 로직에서는

성능 차이가 존재할 수 있다는 것과, 그 차이가 서비스에서 의미 있다는 것은 다른 문제다.

라고 생각한다.

성능이 의심된다면 감으로 결정할 것이 아니라 실제 측정을 하는 것이 맞다.


3. 단순한 데이터 가공은 Stream이 확실히 읽기 좋다

예를 들어 주문 목록에서 결제가 완료된 주문만 가져온다고 해보자.

for문을 사용하면

List<Order> paidOrders = new ArrayList<>();

for (Order order : orders) {
    if (order.isPaid()) {
        paidOrders.add(order);
    }
}

Stream은

List<Order> paidOrders = orders.stream()
        .filter(Order::isPaid)
        .toList();

이다.

나는 이런 경우라면 거의 Stream을 선택한다.

코드를 읽으면 그대로 의미가 전달되기 때문이다.

orders에서
paid인 것만
List로 가져온다.

Stream의 장점은 단순히 코드가 짧다는 것이 아니다.

무엇을 하려는 코드인지 표현하기 쉽다는 것이다.


4. map 역시 Stream이 잘 어울린다

Entity 목록을 DTO 목록으로 변환한다고 해보자.

for문이라면

List<OrderDTO> result = new ArrayList<>();

for (Order order : orders) {
    result.add(OrderDTO.from(order));
}

Stream이라면

List<OrderDTO> result = orders.stream()
        .map(OrderDTO::from)
        .toList();

나는 후자가 더 명확하다고 생각한다.

특히

orders.stream()
        .filter(Order::isPaid)
        .map(OrderDTO::from)
        .toList();

정도라면 굉장히 자연스럽다.

주문 중
결제된 주문만 골라
DTO로 변환한다.

코드가 처리 과정 자체를 설명하고 있다.

이런 것이 Stream의 가장 큰 장점이라고 생각한다.


5. 하지만 Stream이 길어지기 시작하면 생각이 달라진다

문제는 사람들이 Stream을 쓰기 시작하면서 모든 것을 Stream으로 해결하려고 할 때 생긴다.

예를 들어 이런 코드가 있다고 해보자.

orders.stream()
        .filter(order -> order.getStatus() != null)
        .filter(order -> {
            if (order.isCanceled()) {
                log.info("취소 주문 : {}", order.getId());
                return false;
            }

            if (order.getPayment() == null) {
                return false;
            }

            return order.getPayment().isSuccess();
        })
        .map(order -> {
            OrderDTO dto = new OrderDTO();
            dto.setOrderId(order.getId());
            dto.setUserName(order.getUser().getName());

            if (order.hasCoupon()) {
                dto.setDiscount(order.getCoupon().getDiscount());
            }

            return dto;
        })
        .toList();

Stream이긴 하다.

하지만 과연 읽기 좋은가?

나는 이런 코드를 만나면 Stream 사용 자체를 다시 생각한다.

Stream의 장점은 데이터 흐름을 선언적으로 보여주는 것인데 람다 안에 비즈니스 로직이 잔뜩 들어가기 시작하면 그 장점이 사라진다.

그럴 바에는 차라리

for (Order order : orders) {

    if (order.getStatus() == null) {
        continue;
    }

    if (order.isCanceled()) {
        log.info("취소 주문 : {}", order.getId());
        continue;
    }

    if (!isValidPayment(order)) {
        continue;
    }

    OrderDTO dto = createOrderDTO(order);
    result.add(dto);
}

쪽이 훨씬 읽기 쉬울 수도 있다.


6. Stream 코드가 길어지면 메서드로 빼는 것도 방법이다

그렇다고 무조건 for문으로 바꿀 필요는 없다.

조건을 의미 있는 메서드로 분리하면 된다.

List<OrderDTO> result = orders.stream()
        .filter(this::isValidOrder)
        .filter(this::isPaymentSuccess)
        .map(this::createOrderDTO)
        .toList();

이 정도라면 다시 읽기가 쉬워진다.

유효한 주문을 찾고
결제 성공 여부를 확인한 뒤
DTO로 변환한다.

여기서 중요한 것은 Stream이냐 for문이냐가 아니다.

비즈니스 로직의 의미가 코드에서 보이느냐다.


7. Stream 내부에서 외부 상태를 바꾸는 코드는 조심한다

내가 Stream에서 별로 좋아하지 않는 형태 중 하나다.

List<OrderDTO> result = new ArrayList<>();

orders.stream()
        .filter(Order::isPaid)
        .forEach(order -> {
            result.add(OrderDTO.from(order));
        });

동작은 한다.

하지만 굳이 이렇게 할 이유가 없다.

List<OrderDTO> result = orders.stream()
        .filter(Order::isPaid)
        .map(OrderDTO::from)
        .toList();

이면 된다.

Stream은 가능하면

입력
 → 가공
 → 결과

형태로 사용하는 것이 좋다.

외부 변수의 상태를 계속 바꾸기 시작하면 Stream을 사용하면서 얻을 수 있는 장점이 줄어든다.

특히 병렬 Stream까지 사용하게 되면 공유 상태 변경은 훨씬 더 위험해질 수 있다.


8. for문이 압도적으로 편한 순간도 있다

예를 들어 처리 도중 특정 조건에서 바로 빠져나와야 한다고 해보자.

for (Order order : orders) {

    if (order.isCanceled()) {
        continue;
    }

    if (order.hasError()) {
        log.error("주문 오류 : {}", order.getId());
        break;
    }

    process(order);
}

이 코드는 이해하기 어렵지 않다.

반대로 이것을 무조건 Stream으로 바꾸려고 하면 코드가 오히려 이상해질 수 있다.

Stream에는 filter, findFirst, takeWhile 등의 다양한 방법이 있지만

사용할 수 있다는 것과 사용하는 것이 좋은 것은 다르다.

나는 명확한 break, continue 흐름이 필요한 로직이라면 for문을 사용하는 데 전혀 거부감이 없다.

오히려 더 적절하다고 생각한다.


9. 디버깅이 복잡한 로직도 for문이 편하다

실무에서는 코드가 항상 예쁘게만 동작하지 않는다.

운영 장애가 발생하면 결국 디버거를 걸어야 한다.

for (Order order : orders) {

    Payment payment = paymentService.find(order);

    if (payment == null) {
        continue;
    }

    Coupon coupon = couponService.find(order);

    int amount = calculate(order, payment, coupon);

    process(order, amount);
}

이런 코드는 한 줄씩 breakpoint를 걸면서

order
payment
coupon
amount

값을 확인하기 편하다.

Stream 안에서 이것저것 처리하다 보면 디버깅할 때 흐름을 따라가기 불편해지는 경우가 있다.

그래서 복잡한 비즈니스 처리 로직은 굳이 Stream으로 만들지 않는다.


10. primitive 데이터를 처리한다면 IntStream도 생각해볼 수 있다

이런 코드를 보자.

int sum = 0;

for (int value : values) {
    sum += value;
}

Stream으로 바꾸면서 무조건

Stream<Integer>

를 사용할 필요는 없다.

Java에는 primitive 타입을 위한

IntStream
LongStream
DoubleStream

이 따로 있다.

예를 들어

int sum = IntStream.of(values)
        .sum();

처럼 사용할 수 있다.

Stream<Integer>를 사용하면 primitive int와 Integer 사이의 boxing/unboxing이 발생할 수 있기 때문에 숫자 연산이 많다면 primitive stream을 활용하는 것도 좋은 선택이다.


11. parallelStream은 더 빠르지 않을까?

Stream 이야기를 하면 거의 반드시 등장하는 것이 있다.

parallelStream()

예를 들어

orders.parallelStream()
        .filter(Order::isPaid)
        .map(OrderDTO::from)
        .toList();

이렇게 한 줄만 바꾸면 병렬 처리가 된다.

그러면 훨씬 빠른 것 아닐까?

반드시 그렇지는 않다.

Oracle 문서에서도 parallel stream이 자동으로 sequential stream보다 빠른 것은 아니며, 데이터의 양이나 CPU 코어 수, 작업 특성 등이 적절해야 실제 이점이 있다고 설명한다.

병렬화를 하려면 데이터를 나누고,

작업 분할
 → 여러 Thread에서 처리
 → 결과 결합

하는 과정이 필요하다.

이 비용보다 실제 작업 비용이 작다면 오히려 느려질 수도 있다.


12. 나는 웹 서버에서 parallelStream을 특히 조심한다

Spring Boot 같은 웹 애플리케이션에서는 더 조심한다.

서버 하나에서 요청 하나만 처리하는 것이 아니기 때문이다.

사용자 A 요청
사용자 B 요청
사용자 C 요청
사용자 D 요청
...

가 동시에 들어온다.

각 요청이 parallelStream()을 적극적으로 사용하기 시작하면 내가 예상한 것과 다른 형태로 Thread 자원을 소비할 수 있다.

특히 그 내부에서

DB 호출
외부 API 호출
파일 처리

같은 작업까지 한다면 더 신중해야 한다.

parallelStream()이라는 한 줄이 너무 간단해서 그렇지,

병렬 처리는 원래 간단한 문제가 아니다.

나는 실제 성능 측정 없이

"병렬이니까 빠르겠지."

라는 이유만으로 parallelStream()을 사용하는 것을 추천하지 않는다.


13. Stream.toList() 사용 시 하나 알아둘 점

요즘 Java 코드에서는 이런 코드를 자주 사용한다.

List<Order> result = orders.stream()
        .filter(Order::isPaid)
        .toList();

깔끔하다.

그런데 하나 알아둘 것이 있다.

Stream.toList()가 반환하는 List는 수정할 수 없는 List다.

따라서

result.add(order);

같은 코드를 실행하면 UnsupportedOperationException이 발생한다.

결과 List를 수정해야 한다면 목적에 맞게

.collect(Collectors.toCollection(ArrayList::new));

같은 방법을 사용할 수 있다.

Stream 문법만 아는 것보다 Stream이 어떤 결과를 만들어내는지 이해하고 사용하는 것이 중요하다.


14. 성능이 정말 중요하다면 어떻게 해야 할까?

여기서 중요한 질문이다.

for문이 빠른가?
Stream이 빠른가?

인터넷 검색으로 결론을 내리지 않았으면 한다.

실제로 해당 코드가 성능상 중요한 지점이라면 측정해야 한다.

Java에서 마이크로 벤치마크를 제대로 하려면 JMH 같은 도구를 사용하는 것이 일반적이다.

단순히

long start = System.currentTimeMillis();

을 앞뒤로 넣고 몇 번 실행해서

"for문이 20ms 빠르다."

라고 판단하면 JVM warm-up, JIT compilation, GC 등 여러 요소 때문에 잘못된 결론을 내릴 수도 있다.

그리고 반드시 실제 서비스 관점에서도 생각해야 한다.

Stream을 for문으로 바꿔 0.1ms를 줄였는데 DB Query 하나가 500ms 걸리고 있다면 우리가 먼저 고쳐야 하는 곳은 반복문이 아니다.


15. 그렇다면 나는 실제로 어떻게 선택할까?

내 기준은 굉장히 단순하다.

조건을 걸러낸다

orders.stream()
        .filter(Order::isPaid)
        .toList();

Stream


데이터를 변환한다

orders.stream()
        .map(OrderDTO::from)
        .toList();

Stream


특정 데이터를 찾는다

orders.stream()
        .filter(order -> order.getId().equals(orderId))
        .findFirst();

Stream


그룹핑한다

orders.stream()
        .collect(Collectors.groupingBy(Order::getStatus));

Stream


여러 조건과 상태 변경이 섞여 있다

for (Order order : orders) {

    if (!order.isPaid()) {
        continue;
    }

    Payment payment = getPayment(order);

    if (payment == null) {
        handlePaymentError(order);
        continue;
    }

    updateOrder(order, payment);
    sendNotification(order);
}

for문


중간에 빠져나가야 한다

for (Order order : orders) {

    if (order.hasError()) {
        break;
    }

    process(order);
}

for문


정말 성능이 중요하다

먼저 측정한다.

그리고 그 결과에 따라 결정한다.


16. 결국 중요한 것은 Stream을 쓰는 것이 아니다

오래 개발하다 보면 특정 기술이나 문법을 사용하는 것 자체가 목적이 되는 경우를 종종 본다.

Stream을 써야 모던 Java다.

혹은

for문이 가장 빠르니까 for문만 써야 한다.

나는 둘 다 좋은 기준이라고 생각하지 않는다.

좋은 코드는 새로운 문법을 많이 사용한 코드도 아니고, 몇 나노초를 무조건 줄인 코드도 아니다.

다른 개발자가 코드를 봤을 때

아, 여기서 이걸 하는구나.

를 빠르게 이해할 수 있어야 한다.

그리고 문제가 발생했을 때 쉽게 수정할 수 있어야 한다.


17. 15년 개발하면서 내린 결론

Java를 오래 사용하면서 오히려 문법에 대한 고집은 줄어들었다.

예전에는

어떤 방식이 더 좋은가?

를 많이 고민했다면 지금은

이 상황에서는 어떤 방식이 더 적절한가?

를 더 많이 고민한다.

Stream은 정말 좋은 기능이다.

특히

filter
map
reduce
grouping
find

처럼 데이터를 어떻게 가공할 것인지 표현할 때 굉장히 강력하다.

반대로 여러 상태가 변하고 복잡한 비즈니스 흐름을 처리해야 한다면 평범한 for문이 훨씬 좋은 코드가 될 수 있다.

그래서 내가 사용하는 기준을 한 문장으로 정리하면 이렇다.

데이터의 흐름을 표현하고 싶으면 Stream, 처리 과정을 표현하고 싶으면 for문을 먼저 생각한다.

그리고 성능이 정말 중요하다면?

그때는 취향으로 결정하지 않는다.

측정하고 결정한다.


한 줄 정리

Stream이 for문보다 느릴 수 있다.

하지만 그것만으로 for문을 선택할 이유는 아니다.

읽기 쉬운 코드를 먼저 선택하고,
성능이 문제가 되는 순간에는 측정한 뒤 결정하자.
반응형

개발자로 일하다 보면 이런 이야기를 꽤 자주 듣는다.

"프리랜서 월 700이면 연봉으로 8,400이잖아. 연봉 7천 직장인보다 훨씬 많이 버는 거 아닌가?"

계산만 보면 맞다.

월 700만 원을 12개월 받으면 8,400만 원이다.

반면 연봉 7,000만 원 직장인은 말 그대로 7,000만 원이다.

무려 1,400만 원 차이다.

그런데 정말 프리랜서가 1,400만 원을 더 버는 걸까?

결론부터 이야기하면 그렇게 단순하게 비교하면 안 된다.

직장인에게는 우리가 연봉이라고 생각하지 않는 돈이 회사에서 추가로 지출되고 있기 때문이다.

이번에는 2026년 기준으로 실제 숫자를 한번 계산해봤다.


우선 조건을 정해보자

비교를 위해 조건을 단순화했다.

직장인

  • 계약연봉 : 7,000만 원
  • 퇴직금 별도
  • 성과급 없음
  • 별도 복지비 제외
  • 4대보험 가입
  • 1년 이상 근무

프리랜서

  • 월 계약금액 : 700만 원
  • 12개월 모두 계약 유지
  • 연 매출 : 8,400만 원
  • 일반적인 3.3% 원천징수 대상 인적용역이라고 가정
  • 부가세는 비교에서 제외
  • 개인 사업경비 제외

그리고 중요한 것이 하나 있다.

프리랜서의 3.3%는 최종 세금이 아니다.

사업소득에 대해 소득세 3%가 원천징수되고 지방소득세까지 포함하면 일반적으로 3.3%가 먼저 빠질 뿐이다. 이후 종합소득세 신고에서 실제 세금이 다시 정산된다. 국세청도 원천징수 대상 사업소득에 대해 3%를 원천징수한다고 안내하고 있다.


1. 일단 겉으로 보이는 금액부터 비교해보자

직장인 연봉 7,000만 원을 월급으로 환산하면

70,000,000 ÷ 12
= 약 5,833,333원

세전 월급 약 583만 원이다.

반면 프리랜서는

월 7,000,000원

이다.

월 세전 금액만 보면 프리랜서가 약 117만 원 많다.

연간으로 보면

구분직장인프리랜서

월 세전 약 583만 원 700만 원
연간 금액 7,000만 원 8,400만 원
차이   +1,400만 원

여기까지만 보면 프리랜서의 압승이다.

그런데 여기서부터 이야기가 달라진다.


2. 직장인의 4대보험은 회사도 돈을 낸다

급여명세서를 보면 국민연금, 건강보험, 장기요양보험, 고용보험이 빠진다.

그래서 흔히

"직장인은 4대보험 때문에 월급을 많이 떼간다."

라고 생각한다.

맞는 말이지만 절반만 맞다.

회사도 상당한 금액을 같이 부담하고 있기 때문이다.

2026년 국민연금 보험료율은 9.5%이고 사업장가입자는 근로자와 회사가 각각 4.75%씩 부담한다. 건강보험과 장기요양보험 역시 근로자와 사용자가 나눠 부담하며, 고용보험 실업급여 계정은 근로자와 사업주가 각각 0.9%를 부담한다.

연봉 7,000만 원을 기준으로 대략 계산해보자.

국민연금 회사 부담

70,000,000 × 4.75%
= 약 3,325,000원

건강보험 + 장기요양보험 회사 부담

2026년 기준 건강보험과 장기요양보험을 합친 직장가입자의 부담률은 전체 약 8.1348%이고 근로자와 회사가 절반씩 부담한다. 

회사 부담분은 약

70,000,000 × 4.0674%
= 약 2,847,000원

이다.

고용보험

근로자 150인 미만 사업장을 기준으로 단순 계산하면 실업급여 사업주 부담 0.9%에 고용안정·직업능력개발 부담 등이 추가된다.

대략

약 805,000원

정도로 볼 수 있다.

그러면 회사가 연봉 이외에 부담하는 사회보험료가 대략

약 6,980,000원

수준이다.

여기에는 업종에 따라 달라지는 산재보험료는 아예 넣지 않았다.


3. 여기에 퇴직금도 있다

이게 꽤 크다.

근로자가 1년 이상 근무하는 경우 계속근로기간 1년에 대해 30일분 이상의 평균임금을 기준으로 퇴직금이 발생한다.

연봉이 7,000만 원이고 매달 급여가 일정하다고 단순하게 가정하면 1년치 퇴직금은 대략 한 달 급여와 비슷하다.

70,000,000 ÷ 12
= 약 5,833,000원

즉,

약 583만 원이다.

물론 실제 퇴직금은 퇴직 전 3개월의 평균임금 등을 기준으로 계산하기 때문에 정확한 금액은 개인마다 달라질 수 있다.

하지만 비교를 위해서는 이 정도로 봐도 충분하다.


4. 그러면 회사가 연봉 7천 직장인에게 실제로 쓰는 돈은?

이제 합쳐보자.

계약연봉

70,000,000원

회사 부담 4대보험

약 6,980,000원

1년치 퇴직금

약 5,830,000원

합계는

70,000,000
+ 6,980,000
+ 5,830,000

= 약 82,810,000원

약 8,281만 원이다.

여기에 산재보험, 복지포인트, 식대지원, 건강검진, 교육비, 장비, 각종 회사 복지가 있다면 실제 회사의 비용은 더 올라간다.

여기서 재미있는 결과가 나온다.


연봉 7천 직장인은 사실 회사 입장에서 약 8,300만 원짜리 인력이다

처음에는 이렇게 비교했다.

직장인 : 7,000만 원

프리랜서 : 8,400만 원

그래서 무려 1,400만 원 차이가 나는 것처럼 보였다.

그런데 회사가 실제 부담하는 금액으로 바꿔보면

직장인 : 약 8,281만 원

프리랜서 : 8,400만 원

차이가 거의 없어진다.

한 달로 환산하면 연봉 7천 직장인의 회사 비용은

82,810,000 ÷ 12
= 약 6,901,000원

이다.

즉 놀랍게도

연봉 7천 직장인 ≒ 월 690~700만 원 프리랜서

정도로 볼 수 있다.

회사 입장에서 보면 둘의 비용은 거의 비슷한 셈이다.


5. 그렇다면 프리랜서 월 700은 실제로 얼마가 들어올까?

월 700만 원에서 일반적인 3.3%를 원천징수한다고 해보자.

7,000,000 × 3.3%
= 231,000원

그러면 통장에 들어오는 돈은

7,000,000 - 231,000
= 6,769,000원

이다.

월 약 676만 9천 원.

연간으로 보면

84,000,000 × 3.3%
= 2,772,000원

따라서 우선 통장에 들어오는 금액은

84,000,000 - 2,772,000
= 81,228,000원

약 8,122만 원이다.

여기까지만 보면 프리랜서가 압도적으로 좋아 보인다.

하지만 여기서 가장 많이 착각하는 것이 있다.

8,122만 원이 프리랜서의 세후 연봉이 아니다.

3.3%는 세금을 미리 낸 것뿐이고 다음 해 종합소득세 신고에서 사업소득을 기준으로 다시 정산해야 한다. 


6. 프리랜서는 보험료도 직접 부담해야 한다

직장인은 국민연금과 건강보험의 절반 정도를 회사가 부담한다.

프리랜서는 상황이 다르다.

예를 들어 국민연금 지역가입자가 된다면 2026년 보험료율 9.5%를 본인이 부담해야 한다. 반면 직장가입자는 근로자가 4.75%, 사용자가 4.75%를 부담한다. 

건강보험 역시 지역가입자가 되면 회사가 절반을 부담해주는 구조가 아니다.

2026년 건강보험료율은 7.19%이며 지역가입자는 소득과 재산 등을 기준으로 보험료가 산정될 수 있기 때문에 사람마다 금액 차이도 크다.

그래서 단순히

8,400만원 - 3.3%

만 계산해서 직장인 실수령액과 비교하면 잘못된 결과가 나올 수 있다.


7. 직장인에게 있지만 프리랜서에게는 없는 것

돈으로 계산하기 어려운 차이도 있다.

대표적인 것이 유급휴가다.

직장인은 연차를 사용한다고 월급이 깎이지 않는다.

월요일에 쉬든 금요일에 쉬든 월급 583만 원은 그대로 들어온다.

반면 프로젝트 계약 방식에 따라 프리랜서는 일을 하지 않은 날이 곧 매출 감소로 이어질 수 있다.

그리고 더 큰 것이 있다.

계약 공백이다.

월 700만 원이라고 해도 12개월을 쉬지 않고 모두 계약해야 연 8,400만 원이다.

만약 프로젝트가 끝난 후 다음 계약까지 한 달이 비면

700 × 11개월
= 7,700만원

이다.

두 달이 비면

700 × 10개월
= 7,000만원

이다.

순식간에 상황이 달라진다.


8. 프리랜서에게 월 700이라는 숫자가 중요한 이유

반대로 프리랜서에게도 장점은 분명하다.

계약을 꾸준히 유지할 수 있고 경비처리를 제대로 하며 자기 시간을 효율적으로 활용할 수 있다면 직장인보다 실제 소득을 높일 여지가 있다.

특히 경력 있는 개발자의 경우 한 회사에 고용되는 대신 프로젝트 단위로 자신의 기술을 판매하는 구조가 더 유리할 수도 있다.

문제는 단순한 숫자 비교다.

연봉 7천
vs
월 700 × 12 = 8,400

만 보고

"프리랜서가 1,400만 원 더 번다."

라고 판단하면 생각보다 큰 부분을 놓치게 된다.


9. 한눈에 비교하면

항목연봉 7천 직장인월 700 프리랜서

계약상 연간 금액 7,000만 원 8,400만 원
월 세전 금액 약 583만 원 700만 원
퇴직금 약 583만 원 없음
회사 부담 사회보험 약 698만 원 없음
회사 총비용 약 8,281만 원 이상 8,400만 원
유급연차 있음 계약에 따라 다름
계약 공백 위험 낮음 있음
3.3% 원천징수 해당 없음 일반적인 인적용역의 경우 해당
세금 정산 연말정산 종합소득세 신고
국민연금·건강보험 회사와 분담 지역가입 시 본인 부담

결국 회사 비용으로 보면

연봉 7천 직장인
≈
월 690~700만 원 프리랜서

라는 꽤 재미있는 결과가 나온다.


10. 그러면 누가 더 많이 버는 걸까?

결론은 조금 의외다.

당장 통장에 들어오는 돈

프리랜서가 많다.

회사가 한 사람을 쓰기 위해 지불하는 비용

거의 비슷하다.

안정성까지 포함하면

직장인이 유리하다.

소득을 더 키울 가능성

프리랜서가 유리하다.

결국

연봉 7천과 월 700은 생각보다 그렇게 큰 차이가 아니다.

오히려 회사 입장에서 보면 거의 같은 가격대의 인력이라고 볼 수 있다.


내가 이 계산을 해보고 느낀 점

연봉을 비교할 때 우리는 항상 내 통장에 찍히는 숫자만 본다.

그런데 회사가 직원을 한 명 고용하는 데 들어가는 비용을 보면 이야기가 꽤 달라진다.

특히 이직하면서

"정규직 연봉이 7천인데 프리랜서 월 700 제안을 받았습니다."

같은 상황이라면 단순히

7,000 vs 8,400

으로 비교해서는 안 된다.

퇴직금, 회사 부담 보험료, 유급휴가, 계약 공백, 종합소득세까지 고려해야 한다.

개인적으로 이 계산에서 가장 재미있었던 부분은 이것이었다.

회사 입장에서 연봉 7천 직장인 한 명을 고용하는 비용은 이미 연 8천만 원을 훌쩍 넘는다.

그래서 프리랜서가 월 700을 요구한다고 해서 회사 입장에서 반드시 비싼 인력인 것도 아니다.

반대로 프리랜서 입장에서도 월 700이라는 숫자가 연봉 8,400만 원짜리 직장인과 동일하다고 생각해서도 안 된다.

고용 형태가 다르면 같은 숫자라도 돈의 가치가 다르다.


※ 이 글은 2026년 보험료율을 바탕으로 단순화해 비교한 내용이다. 실제 세금, 건강보험료, 국민연금, 퇴직금 등은 개인의 소득, 가족관계, 비과세 항목, 사업경비, 재산, 계약 형태 등에 따라 달라질 수 있다.

반응형

'궁금증' 카테고리의 다른 글

그림을 그릴수 있는 인공지능 AI 종류  (0) 2024.05.13
B2B , B2C 뭐가 다른거야?  (0) 2024.04.29
태양열 에너지를 획득하는 구조  (0) 2024.04.29

AWS CodePipeline을 이용해 CodeBuild를 실행하던 중 갑자기 아래와 같은 오류가 발생했다.

Error calling startBuild:
User: arn:aws:sts::<ACCOUNT_ID>:assumed-role/AWSCodePipelineServiceRole-common/...
is not authorized to perform: iam:PassRole
on resource: arn:aws:iam::<ACCOUNT_ID>:role/code-build-role
because no identity-based policy allows the iam:PassRole action

(Service: AWSCodeBuild; Status Code: 400; Error Code: AccessDeniedException)

처음 보면 CodeBuild의 권한 문제처럼 보인다.

하지만 에러 메시지를 자세히 보면 실제로 권한이 부족한 주체는 CodeBuild가 아니라 CodePipeline의 Service Role이다.

이번 글에서는 iam:PassRole이 무엇인지, 왜 CodePipeline 실행 과정에서 이 오류가 발생하는지, 그리고 어떻게 해결했는지 정리해본다.


1. 에러 메시지에서 가장 먼저 볼 부분

에러 전체를 볼 필요 없이 아래 두 부분을 확인하면 된다.

User:
arn:aws:sts::<ACCOUNT_ID>:assumed-role/AWSCodePipelineServiceRole-common/...

그리고

is not authorized to perform: iam:PassRole
on resource:
arn:aws:iam::<ACCOUNT_ID>:role/code-build-role

이를 그대로 해석하면 다음과 같다.

AWSCodePipelineServiceRole-common 역할이
code-build-role을 AWS 서비스에 전달할 권한이 없다.

즉 수정해야 할 대상은 보통 다음 역할이다.

AWSCodePipelineServiceRole-common

code-build-role에 iam:PassRole을 추가하는 것이 아니다.

이 부분에서 처음 AWS IAM을 다룰 때 많이 헷갈린다.


2. iam이란?

AWS에서는 어떤 서비스가 다른 IAM Role을 사용하도록 지정하는 경우가 있다.

예를 들어 구조가 다음과 같다고 해보자.

CodePipeline
    ↓
CodeBuild
    ↓
code-build-role

CodePipeline이 CodeBuild를 실행하면서 CodeBuild가 사용할 IAM Role을 지정한다면 AWS 입장에서는 이런 질문을 한다.

"CodePipeline이 이 역할을 CodeBuild에게 넘겨줘도 되는가?"

이때 필요한 권한이

iam:PassRole

이다.

중요한 점은 PassRole이 해당 Role의 권한을 직접 실행한다는 의미가 아니라는 것이다.

특정 AWS 서비스가 해당 Role을 사용할 수 있도록 전달할 권한이라고 이해하면 쉽다.


3. 왜 기존에는 됐는데 갑자기 오류가 발생할까?

CodePipeline과 CodeBuild를 구성하다 보면 다음과 같은 상황에서 이런 문제가 발생할 수 있다.

  • CodeBuild Service Role을 새로 만들었을 때
  • 기존 CodeBuild Role을 다른 Role로 변경했을 때
  • CodePipeline의 Build Action 설정을 변경했을 때
  • Pipeline에서 CodeBuild Service Role Override를 사용했을 때
  • IAM Policy를 최소 권한 방식으로 수정했을 때
  • 다른 Pipeline의 공통 Service Role을 재사용했을 때

특히 여러 프로젝트가 하나의 CodePipeline Service Role을 공통으로 사용하는 경우 새로운 CodeBuild Role을 만들면 기존 정책에 해당 Role이 포함되어 있지 않을 수 있다.


4. 해결 방법

IAM에서 CodePipeline이 사용하고 있는 Service Role을 찾는다.

이번 사례라면 다음 역할이다.

AWSCodePipelineServiceRole-common

AWS Console에서

IAM
→ Roles
→ AWSCodePipelineServiceRole-common
→ Permissions

으로 이동한다.

기존 정책을 수정하거나 별도의 Inline Policy를 추가한다.

그리고 다음 권한을 추가한다.

{
  "Effect": "Allow",
  "Action": [
    "iam:PassRole"
  ],
  "Resource": "arn:aws:iam::<ACCOUNT_ID>:role/code-build-role"
}

<ACCOUNT_ID>는 자신의 AWS Account ID로 변경한다.

예를 들어 CodeBuild에서 사용하는 역할이

arn:aws:iam::123456789012:role/code-build-role

이라면 다음처럼 된다.

{
  "Effect": "Allow",
  "Action": [
    "iam:PassRole"
  ],
  "Resource": "arn:aws:iam::123456789012:role/code-build-role"
}

정책을 저장하고 CodePipeline을 다시 실행한다.


5. 조금 더 안전하게 설정하기

아래처럼 단순하게 설정하는 것도 동작한다.

{
  "Effect": "Allow",
  "Action": "iam:PassRole",
  "Resource": "arn:aws:iam::123456789012:role/code-build-role"
}

하지만 나는 가능하면 어떤 서비스에 Role을 전달할 수 있는지도 제한하는 편을 선호한다.

{
  "Effect": "Allow",
  "Action": "iam:PassRole",
  "Resource": "arn:aws:iam::123456789012:role/code-build-role",
  "Condition": {
    "StringEquals": {
      "iam:PassedToService": "codebuild.amazonaws.com"
    }
  }
}

이렇게 하면 해당 Role을 아무 AWS 서비스에나 전달할 수 있는 것이 아니라 CodeBuild에 전달하는 경우로 제한할 수 있다.

IAM은 운영하다 보면 편하다는 이유로 권한을 크게 주기 쉬운데, 가능하면 필요한 Role과 서비스만 지정하는 것이 좋다.


6. Resource에 *를 넣으면 안 될까?

물론 아래와 같이 설정하면 대부분 문제가 해결된다.

{
  "Effect": "Allow",
  "Action": "iam:PassRole",
  "Resource": "*"
}

하지만 운영 환경에서는 추천하지 않는다.

iam:PassRole은 생각보다 중요한 권한이다.

권한을 가진 주체가 높은 권한의 IAM Role까지 임의로 다른 서비스에 전달할 수 있게 되면 권한 상승 문제로 이어질 수 있기 때문이다.

따라서 가능하면

Resource: *

보다는

Resource:
arn:aws:iam::<ACCOUNT_ID>:role/code-build-role

처럼 실제 필요한 Role만 명시하는 것이 좋다.


7. 그래도 실패한다면 확인할 것

iam:PassRole을 추가했는데도 CodeBuild가 실행되지 않는다면 다음 항목을 차례대로 확인해본다.

CodePipeline에 StartBuild 권한이 있는지

Pipeline Service Role에는 CodeBuild를 실행할 권한도 필요하다.

예를 들면 다음과 같다.

{
  "Effect": "Allow",
  "Action": [
    "codebuild:StartBuild",
    "codebuild:BatchGetBuilds"
  ],
  "Resource": "arn:aws:codebuild:ap-northeast-2:123456789012:project/my-project"
}

iam:PassRole과 codebuild:StartBuild는 서로 다른 권한이다.

따라서 에러 메시지가

codebuild:StartBuild

인지

iam:PassRole

인지 먼저 구분해야 한다.


8. CodeBuild Role의 Trust Relationship도 확인한다

CodeBuild가 사용하는 Role이라면 Trust Relationship에 CodeBuild가 해당 Role을 Assume할 수 있도록 설정되어 있어야 한다.

일반적으로 다음과 같은 형태다.

{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Service": "codebuild.amazonaws.com"
      },
      "Action": "sts:AssumeRole"
    }
  ]
}

정리하면 권한의 방향이 서로 다르다.

CodePipeline
    |
    | iam:PassRole
    ↓
code-build-role

CodeBuild
    |
    | sts:AssumeRole
    ↓
code-build-role

이 관계를 이해하면 IAM 문제를 볼 때 훨씬 수월하다.


9. 내가 처음 헷갈렸던 부분

에러에

role/code-build-role

이라고 나오기 때문에 처음에는 자연스럽게

code-build-role에 PassRole을 추가해야 하나?

라고 생각하기 쉽다.

하지만 에러에서 중요한 것은 resource보다 User 부분이다.

User:
assumed-role/AWSCodePipelineServiceRole-common

AWS 권한 오류를 볼 때는 항상 다음 순서로 보는 습관을 들이면 좋다.

누가(User)
→ 무엇을(Action)
→ 어떤 대상(Resource)에
→ 하지 못했는가

이번 오류에 적용하면 다음과 같다.

누가
AWSCodePipelineServiceRole-common

무엇을
iam:PassRole

어떤 대상에
code-build-role

결과
AccessDenied

따라서 답은 자연스럽게 나온다.

AWSCodePipelineServiceRole-common

에

code-build-role에 대한 iam:PassRole

을 허용해야 한다.


10. 최종 정리

AWS CodePipeline에서 다음 오류가 발생한다면

is not authorized to perform: iam:PassRole

가장 먼저 에러 메시지의 User를 확인한다.

CodePipeline Service Role이 표시되어 있다면 해당 Role에 CodeBuild Service Role을 전달할 수 있는 iam:PassRole 권한을 추가하면 된다.

최소한의 설정은 다음과 같다.

{
  "Effect": "Allow",
  "Action": "iam:PassRole",
  "Resource": "arn:aws:iam::<ACCOUNT_ID>:role/code-build-role"
}

조금 더 제한하고 싶다면 다음과 같이 CodeBuild에서만 사용할 수 있도록 설정한다.

{
  "Effect": "Allow",
  "Action": "iam:PassRole",
  "Resource": "arn:aws:iam::<ACCOUNT_ID>:role/code-build-role",
  "Condition": {
    "StringEquals": {
      "iam:PassedToService": "codebuild.amazonaws.com"
    }
  }
}

AWS IAM 오류는 처음 보면 굉장히 복잡해 보이지만 대부분 에러 메시지 안에 답이 있다.

앞으로 AccessDeniedException을 만났다면 우선 이것부터 확인해보자.

1. 누가(User)
2. 어떤 Action을
3. 어떤 Resource에
4. 수행하지 못했는가

이 네 가지만 분리해도 상당수 IAM 오류의 원인을 빠르게 찾을 수 있다.


관련 키워드

AWS CodePipeline, AWS CodeBuild, iam:PassRole, AccessDeniedException, AWS IAM, CodePipeline 권한 오류, CodeBuild 권한 오류, AWS 배포 오류

반응형

Field Injection은 Spring Framework와 같은 의존성 주입(Dependency Injection) 프레임워크에서 사용되는 주입 방법 중 하나입니다. Field Injection은 클래스의 멤버 변수 (필드)에 어노테이션을 사용하여 의존성을 주입하는 방식입니다. 예를 들어, @Autowired 어노테이션을 사용하여 필드에 의존성을 주입하는 것이 Field Injection의 예입니다.

Field Injection이 좋지 않은 이유는 다음과 같습니다:

  1. 의존성이 숨겨짐: Field Injection을 사용하면 의존성이 클래스의 필드에 직접 주입되므로, 이를 클래스의 생성자나 메서드 매개변수를 통해 명시적으로 주입하는 것보다 의존성이 숨겨질 수 있습니다. 이로 인해 클래스의 의존성 관계가 명확하지 않고, 코드의 가독성과 유지보수성이 저하될 수 있습니다.
  2. 테스트 어려움: Field Injection을 사용하면 테스트 시 해당 필드에 대한 의존성을 주입하기 어려울 수 있습니다. 특히 단위 테스트에서 이 필드에 대한 가짜 (모의) 의존성을 주입하거나 값을 모의하는 것이 어려울 수 있습니다.
  3. 의존성 주입 순서 문제: Field Injection은 의존성 주입 순서에 따른 문제를 일으킬 수 있습니다. 예를 들어, 필드를 초기화하기 위해 다른 의존성이 먼저 주입되어야 하는 경우, 순서 문제로 인해 예기치 않은 동작이 발생할 수 있습니다.
  4. 클래스에 직접 접근: Field Injection을 사용하면 클래스의 필드에 직접 접근이 가능하므로, 클래스 내부의 상태를 변경하거나 다른 객체와 상호작용하는 부분에서 의존성 주입을 통제하기 어려워질 수 있습니다.
  5. 의존성 관리 어려움: Field Injection을 사용하면 클래스가 여러 개의 의존성을 가질 때 어떤 의존성이 주입되었는지 명확하게 파악하기 어려울 수 있습니다.

그러므로, 대부분의 경우에는 Constructor Injection 또는 Setter Injection과 같은 명시적인 의존성 주입 방법을 사용하는 것이 권장됩니다. 이러한 방식을 사용하면 의존성 관리와 테스트 용이성을 향상시키고, 코드의 가독성을 향상시킬 수 있습니다. Field Injection은 간단한 코드에서는 사용될 수 있지만, 대규모 또는 복잡한 프로젝트에서는 피하는 것이 좋습니다.

반응형

T000000001 T000000002 T000000003 T000000004 T000000005 ... 의 유형에서 한개씩 늘어나게 코딩 하는 자바 코드


public class NextString {
    public static String getNextString(String currentString) {
        String prefix = currentString.substring(0, 1); // 문자열의 첫 글자 (여기서는 "T") 추출
        int number = Integer.parseInt(currentString.substring(1)); // 숫자 부분 추출 후 정수로 변환

        // 다음 문자열을 만들기 위해 숫자 부분에 1을 더하고, 다시 문자열로 변환
        String nextNumber = String.format("%09d", number + 1);

        // 다음 문자열을 반환
        return prefix + nextNumber;
    }

    public static void main(String[] args) {
        String currentString = "T000000001"; // 입력된 문자열
        String nextString = getNextString(currentString); // 다음 문자열 계산
        System.out.println(nextString); // 결과 출력
    }
}

반응형
  1. Generative Adversarial Networks (GANs): GANs은 이미지를 생성하는 데 사용되는 딥러닝 모델 중 하나입니다. 이 모델은 생성자와 판별자라는 두 개의 신경망으로 구성되어 있으며, 서로 경쟁하면서 고품질의 이미지를 생성합니다.
  2. Convolutional Neural Networks (CNNs): CNNs은 이미지 인식 및 생성에 널리 사용되는 딥러닝 모델입니다. 이러한 모델은 이미지의 특징을 추출하고, 그림을 그리거나 이미지를 분류하는 데 사용될 수 있습니다.
  3. Variational Autoencoders (VAEs): VAEs는 이미지 생성을 위한 확률적 생성 모델로 사용됩니다. 이 모델은 잠재 공간에서 이미지를 생성하고, 실제 이미지와 유사한 샘플을 생성할 수 있습니다.
  4. Pix2Pix: Pix2Pix는 이미지 변환에 사용되는 딥러닝 모델 중 하나입니다. 이 모델은 입력 이미지를 다른 스타일의 이미지로 변환하는데 사용될 수 있으며, 예를 들어 세그먼테이션, 색칠, 스타일 변환 등에 사용될 수 있습니다.
  5. OpenAI의 DALL-E: DALL-E는 텍스트 설명을 받아들여 그에 맞는 이미지를 생성하는데 사용되는 딥러닝 모델입니다. 이 모델은 텍스트에 기반하여 상상력이 풍부한 그림을 생성할 수 있습니다.
반응형

클로드의 예시

import org.springframework.http.HttpHeaders;
import org.springframework.http.MediaType;
import org.springframework.web.reactive.function.BodyInserters;
import org.springframework.web.reactive.function.client.WebClient;

import com.example.model.Data;

public class WebClientExample {

    public static void main(String[] args) {
        WebClient webClient = WebClient.create("http://example.com");

        Data data = new Data("Sample Data");

        webClient.post()
                .uri("/api/data")
                .contentType(MediaType.APPLICATION_JSON)
                .body(BodyInserters.fromValue(data))
                .retrieve()
                .bodyToMono(String.class)
                .map(ResponseEntity::ok)
                .onErrorResume(WebClientResponseException.class,
                        ex -> ex.getRawStatusCode() == 404 ? Mono.just(ResponseEntity.notFound().build()) : Mono.error(ex))
                .subscribe(response -> handleResponse(response));
    }

    private static void handleResponse(Object response) {
        System.out.println("Response received: " + response);
    }
}


이를 응용 하여 


@Configuration 에 빈으로 등록


private HttpClient httpClientConfig(int sec){
    int timeOut = sec * 1000;
    return HttpClient.create()
            .option(ChannelOption.CONNECT_TIMEOUT_MILLIS, timeOut)
            .responseTimeout(Duration.ofMillis(timeOut))
            .doOnConnected(conn -> conn
                    .addHandlerLast(new ReadTimeoutHandler(timeOut, TimeUnit.MILLISECONDS))
                    .addHandlerLast(new WriteTimeoutHandler(timeOut, TimeUnit.MILLISECONDS)));
}

private ExchangeStrategies exchangeStrategiesConfig(){
    ExchangeStrategies exchangeStrategies = ExchangeStrategies.builder()
            .codecs(configurer -> configurer.defaultCodecs().maxInMemorySize(1024*1024*50))
            .build();
    exchangeStrategies
            .messageWriters().stream()
            .filter(LoggingCodecSupport.class::isInstance)
            .forEach(writer -> ((LoggingCodecSupport)writer).setEnableLoggingRequestDetails(true));

    return exchangeStrategies;
}

private ExchangeFilterFunction logRequest(){
    return ExchangeFilterFunction.ofRequestProcessor(
            clientRequest -> {
                log.debug("Request: {} {}", clientRequest.method(), clientRequest.url());
                clientRequest.headers().forEach((name, values) -> values.forEach(value -> log.debug("{} : {}", name, value)));
                return Mono.just(clientRequest);
            }
    );
}

private ExchangeFilterFunction logResponse(){
    return ExchangeFilterFunction.ofResponseProcessor(
            clientResponse -> {
                log.debug("Response: {}", clientResponse.statusCode());
                clientResponse.headers().asHttpHeaders().forEach((name, values) -> values.forEach(value -> log.debug("{} : {}", name, value)));
                return Mono.just(clientResponse);
            }
    );
}

@Bean(name = "testWebClient")
    public WebClient testWebClient() {
        return WebClient.builder()
                .clientConnector(new ReactorClientHttpConnector(httpClientConfig(15)))
                .baseUrl("http://localhost:8080")
                .exchangeStrategies(exchangeStrategiesConfig())
                .filter(logRequest())
                .filter(logResponse())
                .build();

    }


어쩌다보니 필터 로깅 하는 거까지 하게 됬습니다.


@Service
@RequiredArgsConstructor
@Slf4j
public class Client {
    private final WebClient testWebClient;

    public Mono<String> testWebClient(final MultiValueMap<String, HttpEntity<?>> formData) {
        return testWebClient.post()
                .uri(uriBuilder -> uriBuilder
                        .path("/test")
                        .build())
                .contentType(MediaType.MULTIPART_FORM_DATA)
                .bodyValue(formData)
                .retrieve()
                .bodyToMono(String.class)
                .doOnNext(responseBody -> log.debug("Body: {}", responseBody.trim()));
    }
}


빈으로 등록한 웹클라이언트를 가져와서 서비스코딩 해주고


MultiValueMap<String, Object> formData = new LinkedMultiValueMap<>();

formData.add("subject", "테스트");

client.testWebClient(formData, fsr.contentLength()).subscribe(
                        responseString -> { //이하생략


반응형

+ Recent posts